学习笔记,会随着学习继续修改,难免有不完整的地方。
Python 工程能力补齐|完整学习路线
1. Python 工程环境管理
1. 为什么需要虚拟环境?
假设你正在开发两个项目:
-
项目 A: AI Agent 服务,需要
pydantic 2.x。 -
项目 B: 旧版 Python 服务,需要
pydantic 1.x。
如果两个项目都向同一个 Python 环境安装依赖,就可能发生版本冲突。
比如,你为了项目 A 升级了 Pydantic,结果项目 B 的代码运行失败。
虚拟环境(Virtual Environment)就是为了解决这类问题。
它允许每个项目拥有自己的一套第三方依赖,不必相互干扰。
和 Docker 有什么区别?你之前已经学习过 Docker,所以可以直接比较:
| 对比 | venv | Docker |
|---|---|---|
| 隔离对象 | Python 环境及依赖 | 应用运行环境 |
| 是否隔离进程 | 否 | 是 |
| 是否隔离网络 | 否 | 通常是 |
| 是否包含操作系统环境 | 否 | 包含容器文件系统和用户空间 |
| 主要用途 | Python 项目依赖管理 | 应用打包与部署 |
可以简单理解:venv 负责 Python 依赖隔离,Docker 负责更大范围的运行环境隔离。
两者不是替代关系。
2. venv 的工作原理
当你执行:
python3 -m venv .venvPython 会创建一个目录,大致结构如下:
.venv/
├── bin/
│   ├── python-Python 解释器入口
│   ├── pip
│   └── activate-用户激活虚拟环境的 Shell 脚本
├── lib/
│   └── python3.x/
│       └── site-packages/-安装第三方依赖的位置
└── pyvenv.cfg
三个关键位置:
-
bin/python:虚拟环境中的 Python 解释器入口。 -
bin/activate:用于激活虚拟环境的 Shell 脚本。 -
site-packages:安装第三方依赖的位置。
这里有一个比较重要的原理:
激活虚拟环境,并不是启动一个新的 Python 进程,而是修改当前 Shell 的环境变量。
其中最关键的是 PATH。
例如,激活前:
PATH=/opt/homebrew/bin:/usr/bin:...激活后:
PATH=/项目路径/.venv/bin:
	 /opt/homebrew/bin:/usr/bin:...
由于 Shell 会按照 PATH 中的顺序查找命令,因此输入 python 时,就会优先找到虚拟环境中的解释器。
3. 练习
这次我们只创建环境、观察变化,不安装任何第三方依赖。
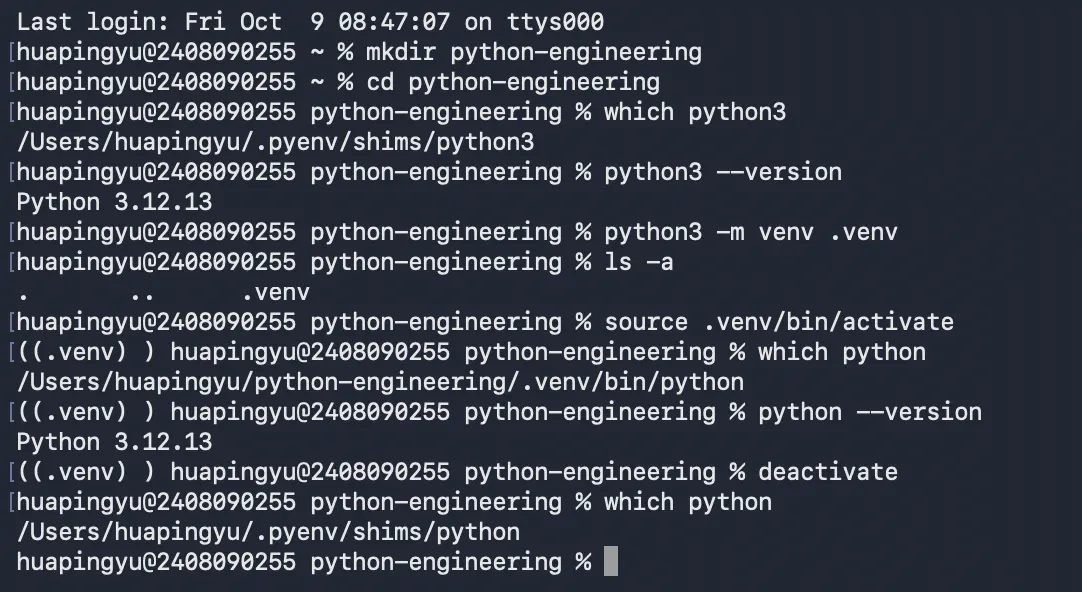
第一步:创建项目目录
打开 Mac 终端:
mkdir python-engineering
cd python-engineering
第二步:查看当前 Python
执行:
which python3
python3 --version
记录一下当前 Python 的位置。
第三步:创建虚拟环境
python3 -m venv .venv创建完成后,执行:
ls -a应该能看到 .venv。
第四步:激活虚拟环境
source .venv/bin/activate终端提示符通常会出现:
(.venv) huapingyu@Mac python-engineering %然后执行:
which python
python --version
此时 which python 应该指向:
.../python-engineering/.venv/bin/python第五步:退出虚拟环境
执行:
deactivate然后再次执行:
which python观察 Python 路径是否发生变化。
注意:退出后,如果系统找不到 python 命令,也不一定是错误。可以使用 which python3 查看系统当前可用的解释器。
4. 不激活虚拟环境,如果使用它?
假设你已经退出虚拟环境,但仍然想使用 .venv 中的 Python 运行 main.py,是否一定要先执行 source .venv/bin/activate?
刚才创建的虚拟环境中有一个 Python 解释器入口:
.venv/bin/python所以可以直接执行:
.venv/bin/python main.py甚至可以直接使用这个环境中的 pip:
.venv/bin/python -m pip list原理:
激活虚拟环境只是修改 PATH,让你输入 python 时自动找到 .venv/bin/python。
但如果你已经明确指定了这个路径,就不需要再修改 PATH。
可以理解为:
-
python main.py:让 Shell 根据PATH寻找 Python。 -
.venv/bin/python main.py:直接指定要使用哪个 Python。
5. 创建 & 激活虚拟环境的区别
创建虚拟环境和激活虚拟环境是两个独立的步骤。
创建后即使没有激活,虚拟环境也是可以正常使用的。
1. 两个步骤的区别
① 创建虚拟环境
python3 -m venv .venv作用:创建 .venv 目录,准备好独立的 Python 解释器入口和依赖安装位置。
② 激活虚拟环境
source .venv/bin/activate作用:修改当前 Shell 的 PATH,让你直接输入 python 时,优先使用 .venv 中的 Python。
二、创建后不激活,可以使用吗?
可以,而且有两种使用方式:
| 状态 | 执行命令 | 使用的 Python |
|---|---|---|
| 已创建,未激活 | python main.py |
当前 PATH 指向的 Python |
| 已创建,未激活 | .venv/bin/python main.py |
虚拟环境 Python |
| 已创建,已激活 | python main.py |
虚拟环境 Python |
所以,激活只是让使用虚拟环境变得方便,并不是使用它的必要条件。
你之前的报错:
can't open file 'main.py'恰恰说明虚拟环境的 Python 已经正常启动了,只是找不到要运行的文件。
三、记住一个核心区别
-
创建: 把虚拟环境准备好。
-
激活: 让当前终端默认使用这个虚拟环境。
-
直接指定路径: 不激活也能使用。
在实际开发中,我们通常会激活虚拟环境,方便反复执行命令;而在自动化脚本、部署等场景中,直接指定虚拟环境的 Python 路径也很常见。
6. 依赖管理
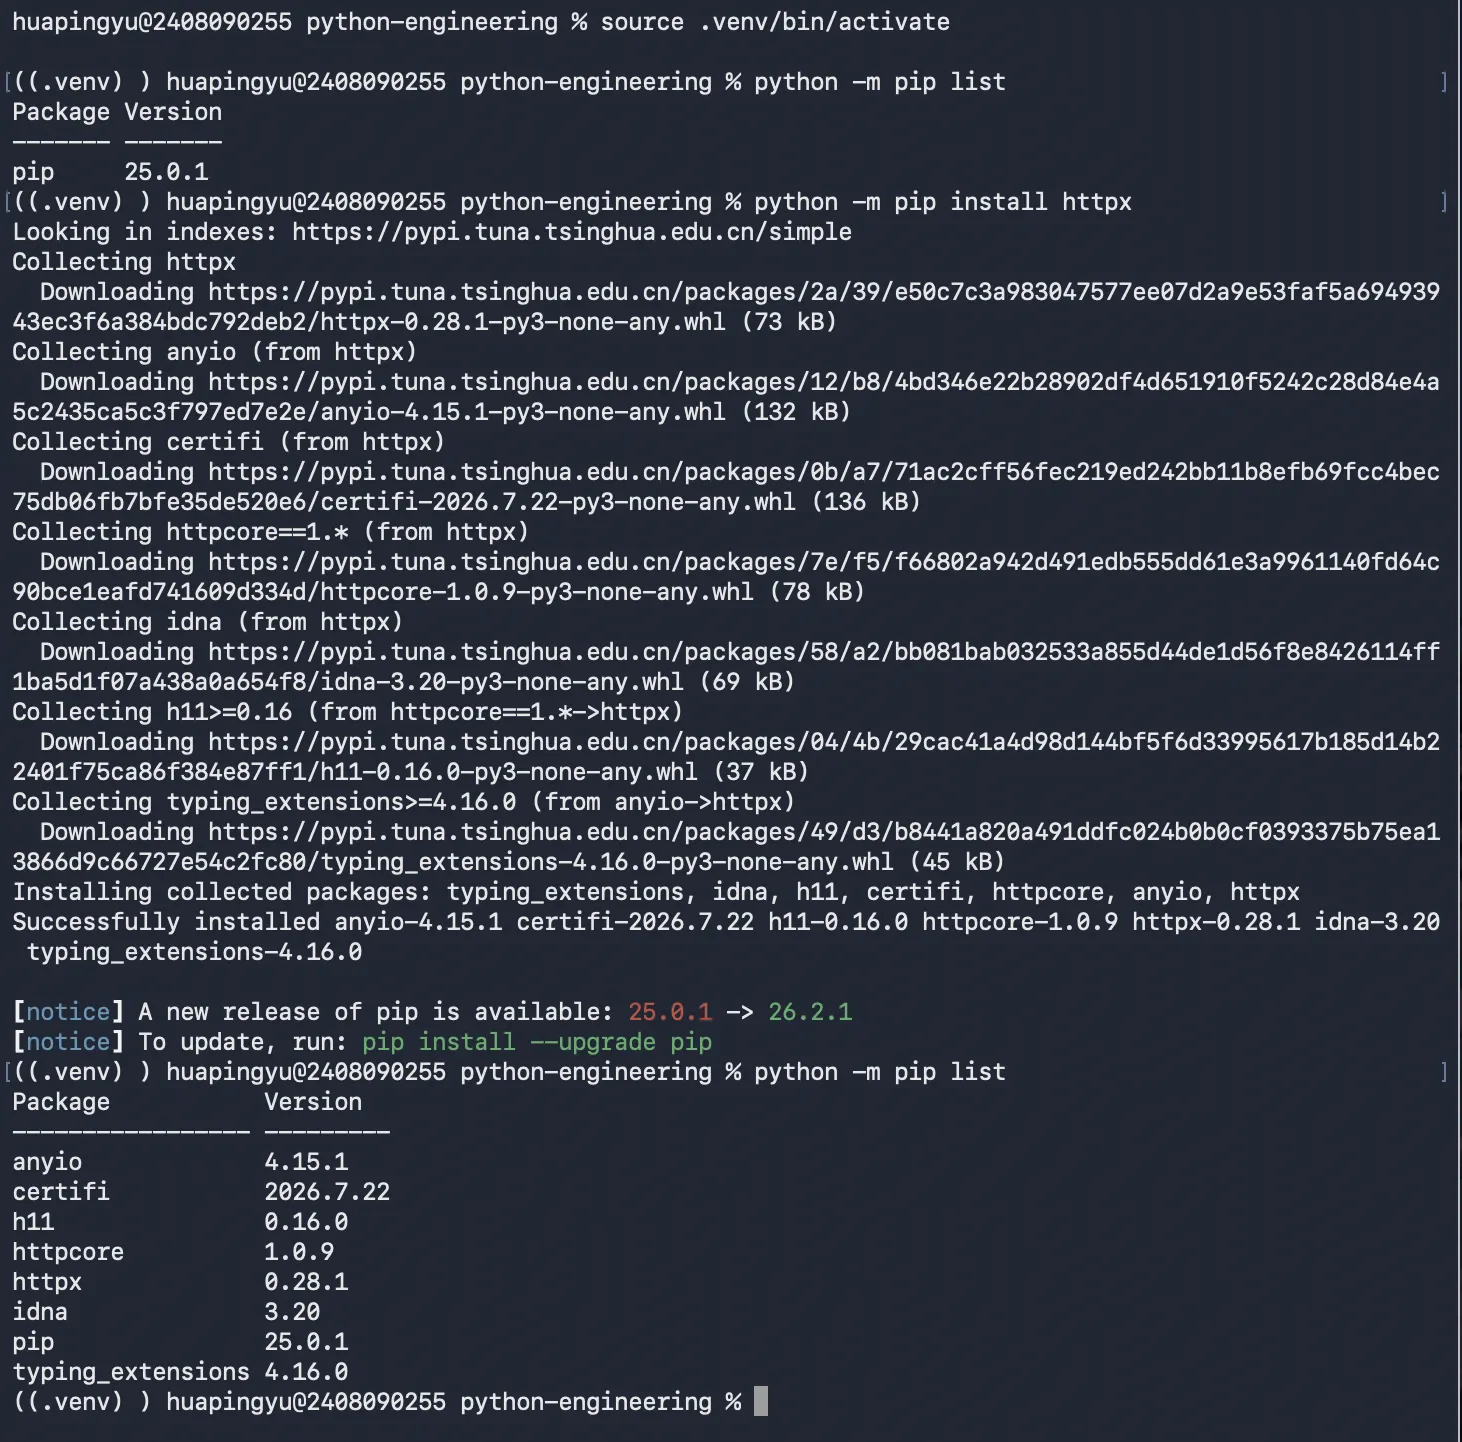
1. 为什么只安装 httpx,却出现了 7 个包?
执行的是:
python -m pip install httpx但实际上安装了:
httpx
├── anyio
│   ├── idna
│   └── typing_extensions
├── certifi
├── httpcore
│   └── h11
└── idna
因为 httpx 本身也依赖其他第三方库。
pip 会读取依赖声明,解析所需版本,并自动安装缺失的依赖。
2. 为什么推荐 python -m pip?
比较两条命令:
pip install httpxpython -m pip install httpx第一条:Shell 根据 PATH 查找 pip 可执行文件。
第二条:先确定使用哪个 python,再让这个解释器运行 pip 模块。
正常情况下,两者的效果相同。
但如果电脑上有多个 Python 环境,例如:
Python A → Python 3.11
Python B → Python 3.12
Python C → 项目虚拟环境
就可能出现:
你以为给 Python C 安装了依赖,实际却安装到了 Python B。
使用 python -m pip 能让安装行为明确绑定到当前指定的 Python 解释器。
不过要注意,它不能自动保证你选择的是正确的 Python;仍然需要确认 python 指向哪里。
3. 练习
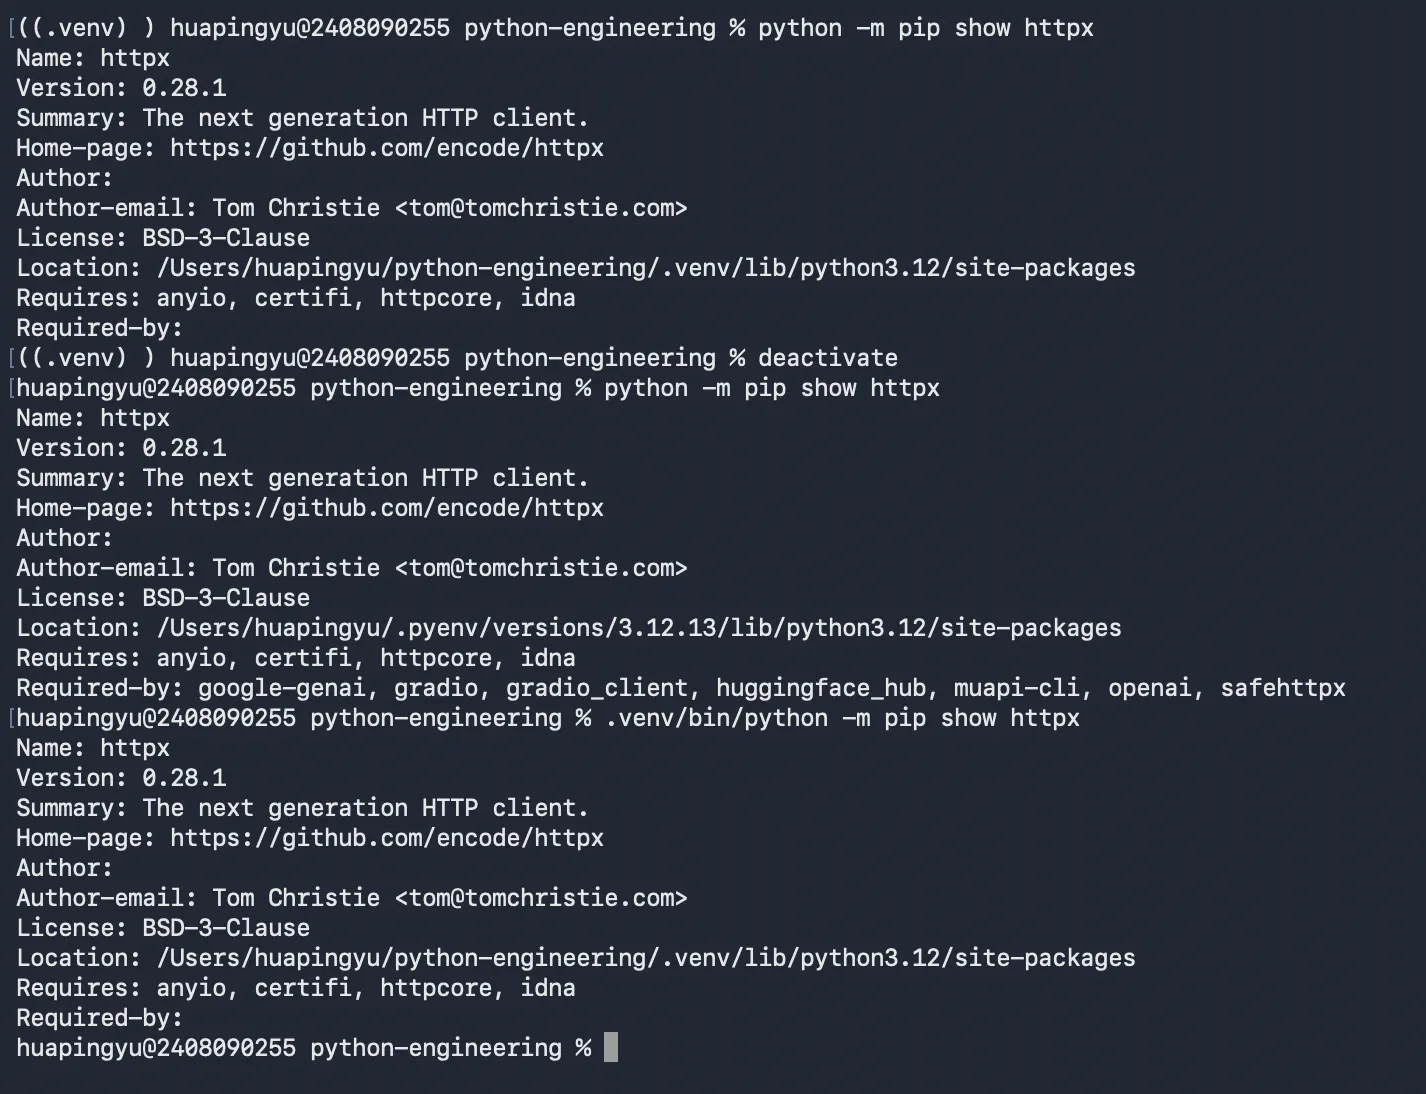
我们验证 httpx 究竟安装在哪里。
目前还在虚拟环境中,执行:
python -m pip show httpx重点观察 Location 字段。
然后退出虚拟环境:
deactivate分别执行:
python -m pip show httpx.venv/bin/python -m pip show httpx观察三次结果。
4. 虚拟环境隔离的到底是什么
退出虚拟环境后仍然能找到 httpx,是不是代表虚拟环境隔离失败了?
先说结论:虚拟环境隔离的是「依赖的安装位置」和「默认搜索范围」,而不是包的名称。
一、电脑上存在两个 Python 环境
环境 A:pyenv 管理的 Python 环境
/Users/huapingyu/.pyenv/versions/3.12.13/
└── lib/python3.12/site-packages/
    ├── httpx
    ├── openai
    └── ...
环境 B:项目的 venv 虚拟环境
/Users/huapingyu/python-engineering/.venv/
└── lib/python3.12/site-packages/
    ├── httpx
    ├── anyio
    └── ...
两个环境中恰好都安装了 httpx 0.28.1。
但它们是两份独立安装的依赖。
二、为什么退出虚拟环境后还能找到 httpx?
当你执行:
deactivate
python -m pip show httpx
deactivate 会恢复之前的 Shell 环境,使 python 不再默认指向 .venv/bin/python。
此时,你使用的是 pyenv 管理的 Python。
而这个 Python 本来就安装了 httpx,所以当然能够找到。
这就像你的 Mac 上安装了两个独立的应用,它们都包含同名的文件,并不意味着两个应用的数据目录没有隔离。
三、什么情况才值得怀疑隔离失败?
假设:
-
环境 A 没有安装
httpx。 -
你只在环境 B 中安装了
httpx。 -
退出环境 B 后,环境 A 居然能够直接导入环境 B 中的
httpx。
这种情况才需要进一步检查是否存在路径污染、启用了系统包访问,或者其他环境配置问题。
注意,两个环境能否导入同一个包,不是判断隔离是否成功的唯一标准;关键是它们实际从哪里加载这个包。
你可以通过以下命令检查:
python -c "import httpx; print(httpx.__file__)".venv/bin/python -c "import httpx; print(httpx.__file__)"它们应该输出两个不同的安装路径。
7. pyproject.toml:Python 项目的依赖声明
1. 为什么需要 pyproject.toml
你在自己的 Mac 上开发了一个 AI 应用,安装了:
python -m pip install fastapi
python -m pip install httpx
python -m pip install pydantic
项目在你的电脑上运行正常。
但当你把项目代码发给别人时,对方并不知道需要安装哪些依赖。
难道要让对方一个一个猜?
显然不合理。
因此,Python 项目需要一个文件来声明项目依赖。
这就是 pyproject.toml 的重要用途之一。
2. 认识 pyproject.toml
如果有 Java Maven 基础,可以这样建立联系:
| Java / Maven | Python |
|---|---|
pom.xml |
pyproject.toml |
| 声明 dependencies | 声明 dependencies |
| 项目名称、版本 | 项目名称、版本 |
| Maven 插件配置 | Python 构建工具配置 |
不过两者并不完全相同。
pyproject.toml 是 Python 项目配置的标准化入口,本身不负责安装依赖。
实际安装和解析依赖仍然需要 pip、uv 等工具。
一个简单的文件长这样:
[project]
name = "python-engineering"
version = "0.1.0"
requires-python = ">=3.12"

dependencies = [
    "httpx>=0.28.1",
]
我们逐项理解:
| 配置 | 含义 |
|---|---|
name |
项目名称 |
version |
项目版本 |
requires-python |
项目支持的 Python 版本范围 |
dependencies |
项目运行所需的直接依赖 |
这里有个非常重要的区别:
声明依赖 ≠ 安装依赖。
你在文件中写下:
dependencies = [
    "httpx>=0.28.1",
]
只是告诉依赖管理工具:这个项目需要 httpx,版本至少为 0.28.1。
它不会因为你保存了文件,就自动出现在虚拟环境里。
另外,>=0.28.1 是一个版本范围,并不意味着一定安装 0.28.1。
3. 练习
继续使用之前的 python-engineering 项目。
第一步:创建 pyproject.toml
在项目根目录执行:
touch pyproject.toml使用 VS Code 或其他编辑器打开它,填入:
[project]
name = "python-engineering"
version = "0.1.0"
requires-python = ">=3.12"

dependencies = [
    "httpx>=0.28.1",
]
保存文件。
第二步:观察项目目录
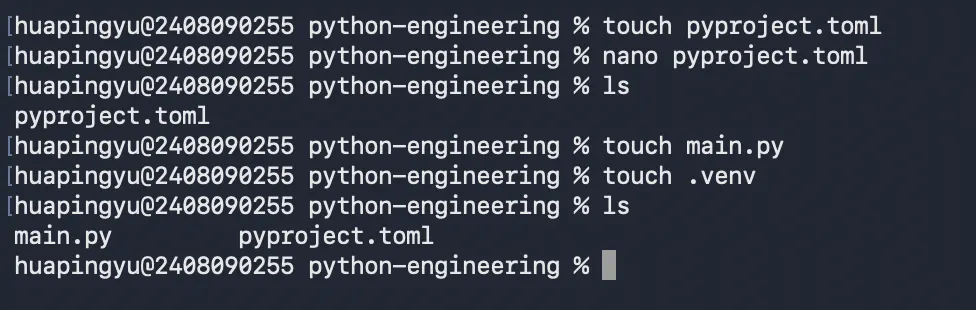
现在你的项目大致应该是:
python-engineering/
├── .venv/
├── main.py
└── pyproject.toml
如果你之前没有创建 main.py,也没关系,这一关暂时用不到它。
第三步:做一个工程判断
现在请你思考:
假设你把这个项目的代码和 pyproject.toml 发给另一位开发者,但没有把 .venv 文件夹发给他。
他能否根据 pyproject.toml 知道项目需要安装什么依赖?
| 文件 | 作用 |
|---|---|
pyproject.toml |
声明项目需要什么依赖,以及允许的版本范围 |
uv.lock |
记录解析后的具体依赖版本和相关锁定信息 |
.venv/ |
实际安装依赖的环境 |
8. uv:现代 Python 项目管理工具
1. uv 到底解决什么问题?
之前我们需要分别使用不同命令:
python3 -m venv .venv
python -m pip install httpx
python main.py
而 uv 可以统一管理这些工作。
例如:
| 需求 | uv 命令 |
|---|---|
| 初始化项目 | uv init |
| 添加依赖 | uv add httpx |
| 删除依赖 | uv remove httpx |
| 同步依赖环境 | uv sync |
| 运行 Python 程序 | uv run python main.py |
特别注意:uv add 不只是安装依赖,它还会更新项目的依赖声明和锁定信息。
2. 检查是否已经安装 uv
在终端执行:
uv --version
3. uv sync
我们已经手动创建了 pyproject.toml,所以不需要再执行 uv init。
现在直接执行:
uv sync这条命令会根据项目配置解析依赖、生成或更新 uv.lock,并同步项目虚拟环境。
由于你已经有 .venv,uv 通常会复用兼容的环境。
执行完成后,再运行:
ls -a观察是否出现:
uv.lock接着执行:
uv run python -c "import httpx; print(httpx.__version__)"如果正常,应该输出一个满足项目依赖要求的 httpx 版本。
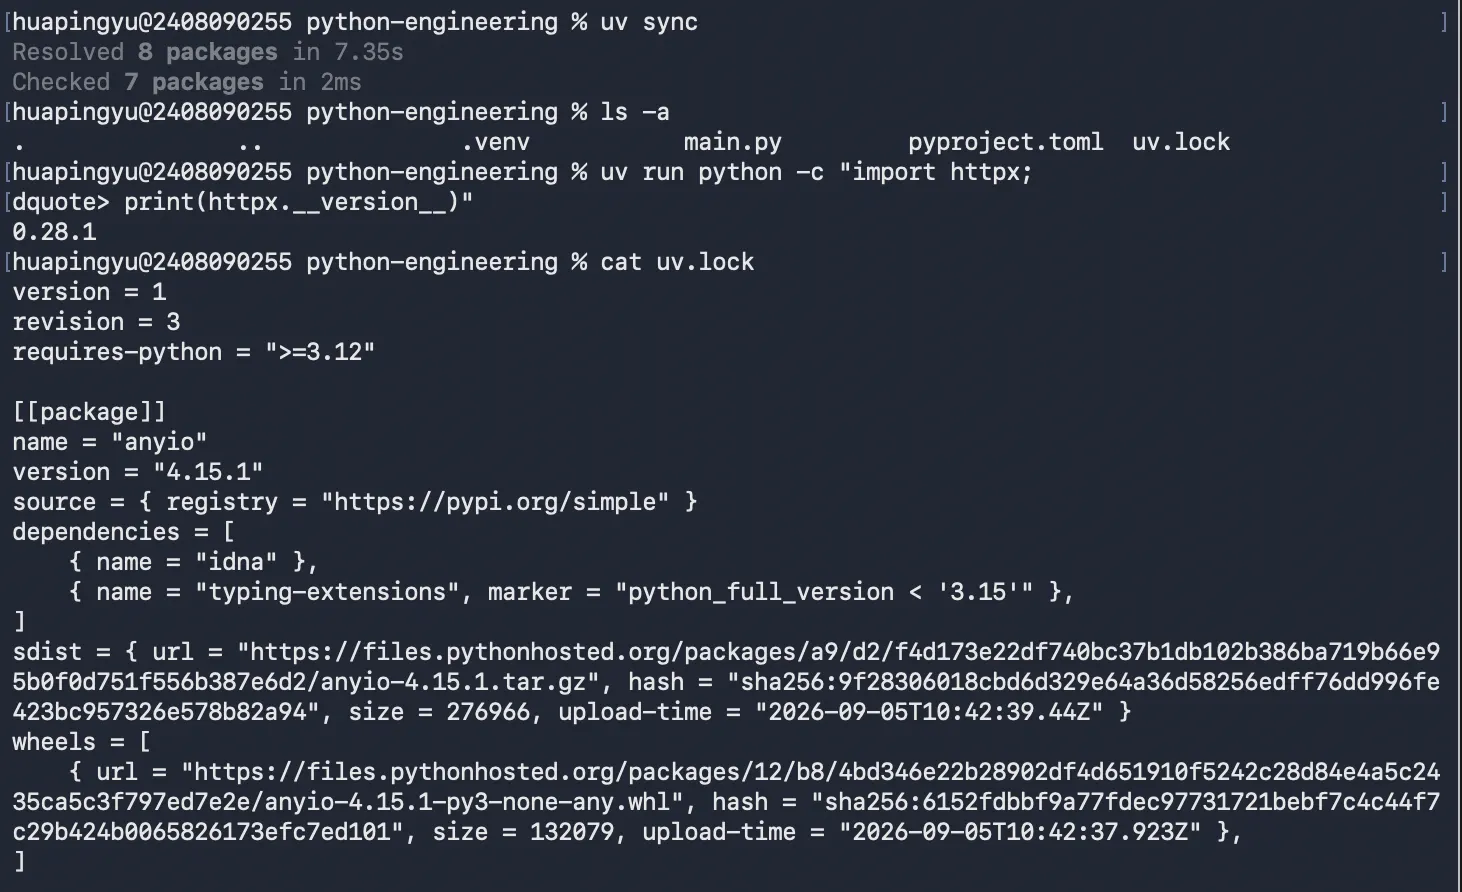
4. uv.lock
你刚才输出了整个 uv.lock,但实际上,我们只需要关注几个字段。
以 httpx 为例:
[[package]]
name = "httpx"
version = "0.28.1"
source = { registry = "https://pypi.org/simple" }

dependencies = [
    { name = "anyio" },
    { name = "certifi" },
    { name = "httpcore" },
    { name = "idna" },
]
这里记录了:
-
name:包名称。
-
version:解析后锁定的具体版本。
-
source:依赖来源。
-
dependencies:这个包依赖哪些其他包。
5. uv add
假设 AI Gateway 项目准备使用 FastAPI 提供 HTTP 服务。
你不需要再手动编辑 pyproject.toml,直接执行:
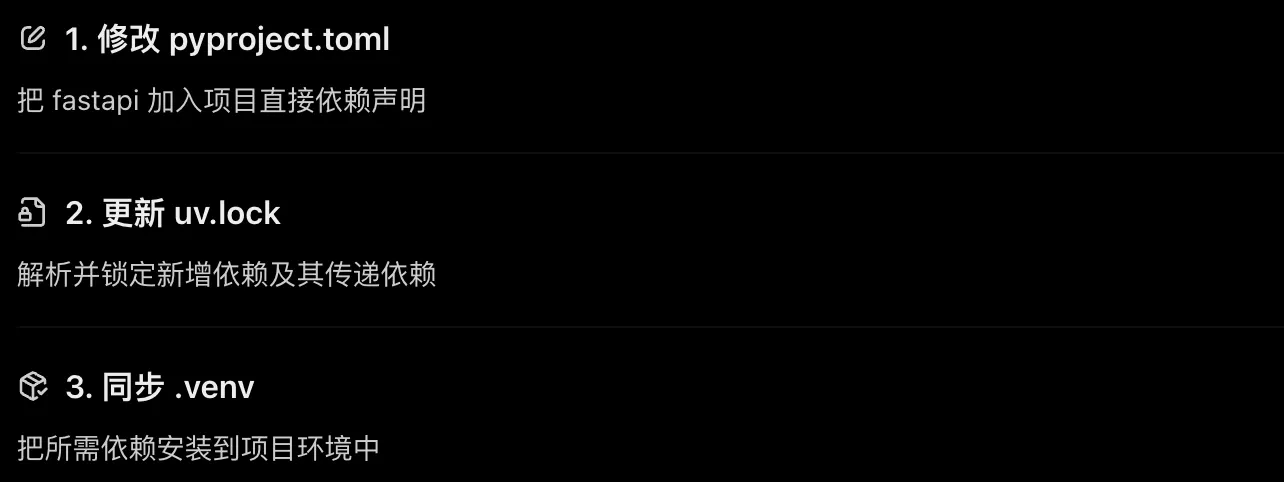
uv add fastapi这条命令通常会自动完成三件事:
在 python-engineering 目录执行:
uv add fastapi然后执行:
cat pyproject.toml最后验证:
uv run python -c "import fastapi; print(fastapi.__version__)"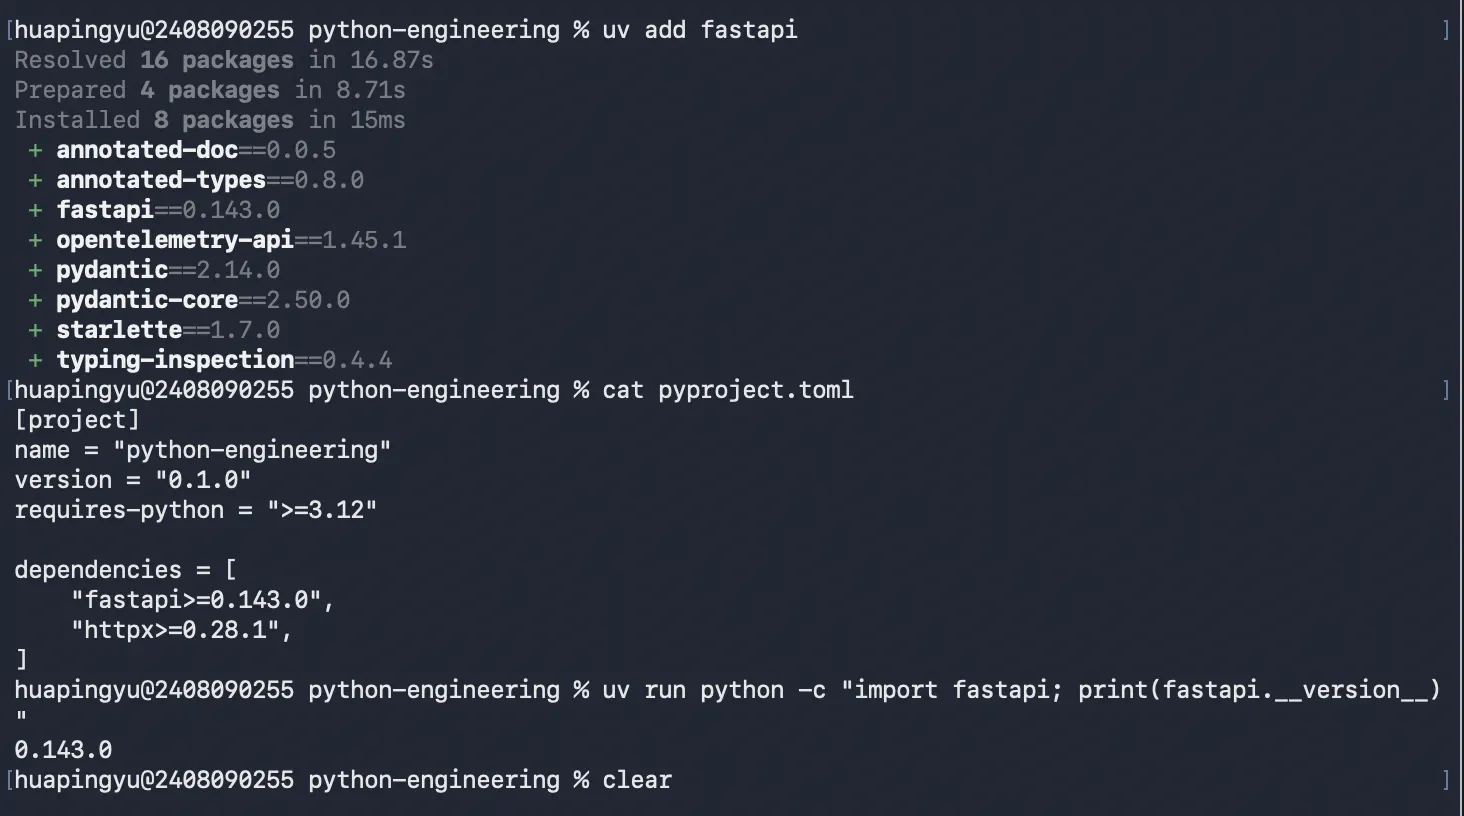
为什么我们只执行了一条 uv add fastapi,却不需要再分别执行 pip install 和 uv sync?
因为 uv add 不只是安装依赖,而是一个完整的项目依赖管理操作。
执行:
uv add fastapi默认会依次完成:
-
更新
pyproject.toml中的依赖声明。 -
解析依赖关系,更新
uv.lock。 -
将解析后的依赖同步到
.venv。
因此不需要再单独执行 pip install 和 uv sync。
6. 区分三个核心命令
| 命令 | 主要用途 |
|---|---|
uv add fastapi |
给项目新增依赖,并更新锁定文件和环境 |
uv sync |
根据项目声明和锁定文件同步环境 |
uv run python main.py |
在项目环境中运行程序,必要时先同步环境 |
这里有一个工程细节:uv sync 默认会移除不属于当前项目依赖集合的多余包,因此不要把 .venv 当作永久存放手动安装软件的地方。
2. Python 项目结构 & 配置管理
1. 为什么需要「模块与包」
假设你正在开发一个 AI Agent 后端。
最初,你可能把所有代码写在一个 main.py 文件中:
# main.py

def call_llm():
    print("调用大模型 API")

def save_message():
    print("保存消息")

def handle_chat():
    call_llm()
    save_message()

handle_chat()
代码只有十几行时,这样写没有问题。
但当项目逐渐增加 API 路由、模型调用、数据处理等功能,所有代码堆在一个文件中,就会变得难以维护。
这时我们需要通过**模块(Module)和包(Package)**组织代码。
2. 模块与包的区别
-
模块: 通常是一个
.py文件。 -
包: 用于组织多个模块的结构,通常表现为一个目录。现代 Python 也支持不包含
__init__.py的命名空间包。
例如:
python-engineering/
├── main.py
├── services/
│   ├── __init__.py
│   └── llm.py
├── pyproject.toml
└── uv.lock
这里:
-
llm.py是模块。 -
services是包。 -
__init__.py让services成为常规 Python 包。
3. 练习
继续使用现有的 python-engineering 项目。
创建目录和文件:
mkdir -p services
touch services/__init__.py
touch services/llm.py
在 services/llm.py 中编写:
def call_llm():
    return "来自大模型的响应"
然后在 main.py 中编写:
from services.llm import call_llm

result = call_llm()
print(result)
运行:
uv run python main.py预期输出:
来自大模型的响应-
ModuleNotFoundError:通常表示模块没有被找到。 -
ImportError: cannot import name:模块可能已经找到,但无法导入指定名称。
4. import 的基本原理
Python 到底是如何找到要导入的模块的?
当 Python 执行:
from services.llm import call_llm它需要完成两件事:
-
找到
services.llm模块。 -
从模块中获取
call_llm这个名称。
1. 那么 Python 去哪里寻找模块呢?
其中一个关键因素就是 sys.path。
它是 Python 的模块搜索路径列表。
例如:
sys.path
├── 当前程序所在目录(取决于启动方式)
├── PYTHONPATH 指定的目录(如果有)
├── Python 标准库目录
└── site-packages 等目录
Python 导入模块时,会使用这些搜索路径,并结合其他导入机制寻找模块。
这也解释了为什么有些 Python 项目会出现:
明明文件存在,但运行时却提示
ModuleNotFoundError。
因为文件存在,不代表它所在的目录一定处于模块搜索范围内。
2. 动手观察 sys.path
继续使用之前的项目:
python-engineering/
├── main.py
└── services/
    ├── __init__.py
    └── llm.py
先执行:
.venv/bin/python -c "import sys; print(*sys.path, sep='\n')"你会看到若干路径。
接着执行:
.venv/bin/python -c "import services.llm; print(services.llm.__file__)"预期输出:
/Users/huapingyu/python-engineering/services/llm.py这说明 Python 找到了对应的模块文件。
3. 再做一个对比实验
现在切换到项目的 services 目录:
cd services然后执行:
../.venv/bin/python -c "import llm; print(llm.__file__)"这次我们不再写 services.llm,而是直接导入 llm。
观察输出。
注意: 我们没有修改任何 Python 代码,只是改变了执行命令时所在的目录和导入方式。
4. PATH & sys.path
| 你的理解 | 判断 |
|---|---|
PATH 服务于 Shell 查找可执行程序 |
正确 |
sys.path 服务于 Python 导入模块和包 |
正确 |
| 两者都涉及根据搜索路径查找目标 | 正确 |
sys.path 通常记录搜索起点,而非模块完整路径 |
正确 |
sys.path 受到 Python 启动方式和工作目录影响 |
正确,但需要补充条件 |
第一个细节:PATH 和 sys.path 不是同一个东西
你说「变化的是 path」,这里可以表达得更准确一些。
实际上是两套不同的搜索机制:
Shell 执行命令
    ↓
读取 PATH 环境变量
    ↓
在指定目录中寻找可执行程序
    ↓
执行程序
Python 执行 import
↓
使用 Python 的导入机制
↓
根据 sys.path 等信息寻找模块或包
↓
加载模块注意,sys.path 只是 Python 导入机制的一部分,并不是所有模块都必须通过它查找。例如内置模块就不需要依赖普通文件路径搜索。
另外,Shell 的 PATH 是环境变量,而 Python 的 sys.path 是一个列表对象。
第二个细节:工作目录不是始终决定 sys.path
这是我们之前容易混淆的地方。
对于:
python -c "import llm"Python 通常会把当前工作目录作为模块搜索位置之一。
但对于:
python services/llm.pyPython 通常会优先把脚本所在目录放入 sys.path。
所以不能简单认为「终端在哪里,Python 就一定从哪里开始搜索」。
5. 项目目录设计
1. 项目目录设计
你之前使用过 Spring Boot,应该比较熟悉这种结构:
src/main/java/com/example/
├── controller/
├── service/
├── repository/
└── config/
这些目录的核心目的,是把不同职责的代码分开。
Python 后端也是类似的思路。
假设我们开发一个 AI 聊天 API,可以采用下面这种结构:
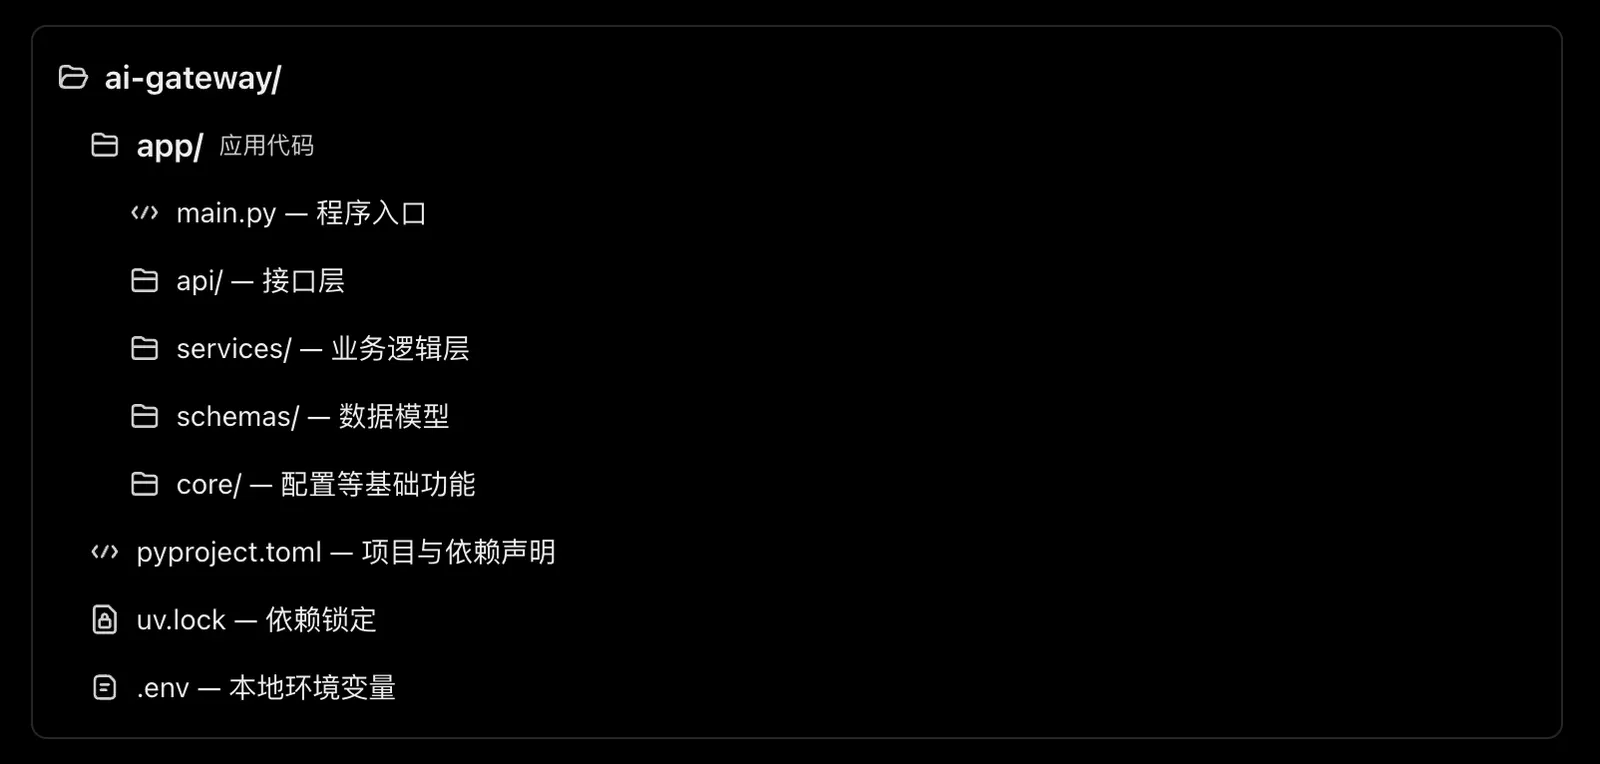
这些目录分别承担什么职责?
| 目录 | 作用 | Spring Boot 类比 |
|---|---|---|
api/ |
接收 HTTP 请求、返回响应 | Controller |
services/ |
处理业务逻辑、调用大模型 | Service |
schemas/ |
定义请求、响应的数据结构 | DTO |
core/ |
配置、日志等基础功能 | Config |
main.py |
创建并启动应用的入口 | Application |
注意:这是一种常见组织方式,不是 Python 强制规定的标准。
项目结构应该随着复杂度增长,而不是一开始就把所有目录建齐。
2. 动手:把现有项目整理成分层结构
这次我们只拆分两个职责:
-
main.py:负责调用业务功能。 -
services/llm.py:负责模拟大模型响应。
你之前已经写过这些代码,所以不用重新创建项目。
当前结构:
python-engineering/
├── main.py
└── services/
    ├── __init__.py
    └── llm.py
我们先保留这个结构,不急着引入 api/、schemas/ 等目录。
第一步:修改业务层
打开:
nano services/llm.py改成:
def generate_response(message: str) -> str:
    return f"AI 收到了你的消息:{message}"
第二步:修改程序入口
打开:
nano main.py改成:
from services.llm import generate_response

message = "你好,请介绍一下自己"

response = generate_response(message)

print(response)
第三步:运行
考虑到之前 uv 的网络超时问题,这次直接使用虚拟环境:
cd ~/python-engineering
.venv/bin/python main.py
预期输出:
AI 收到了你的消息:你好,请介绍一下自己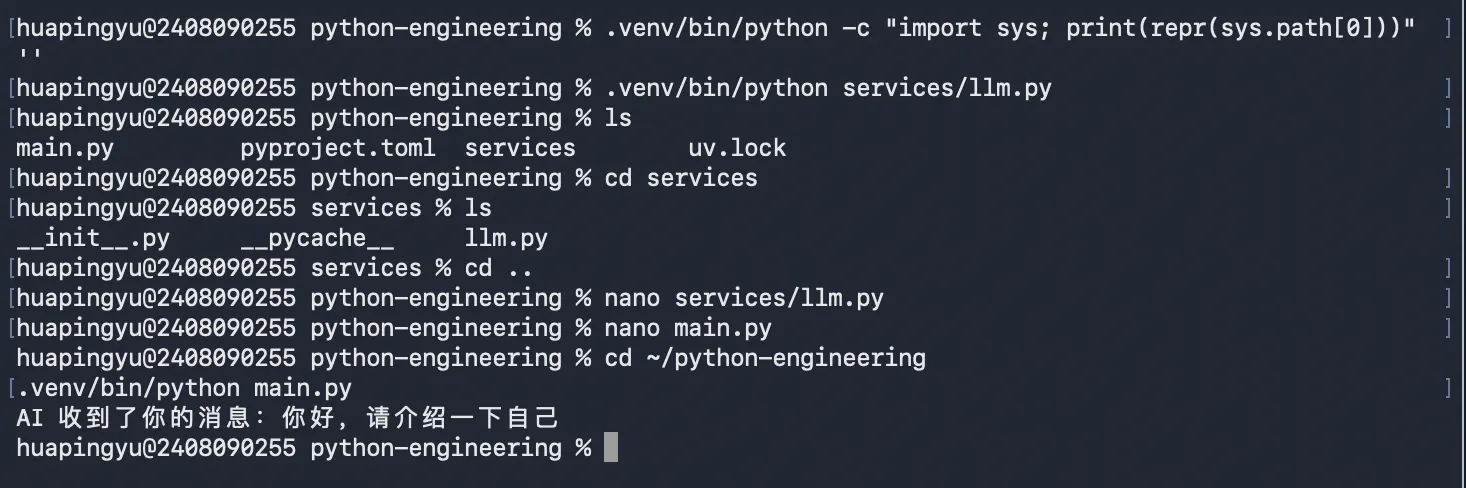
3. 这次需要掌握的工程原则
让代码按照职责组织,而不是按照代码量随意拆分。
例如,未来真正接入 FastAPI 后:
-
API 层负责接收用户消息。
-
Service 层负责调用大模型。
-
Schema 层负责验证消息格式。
API 层不应该承担全部的大模型调用、数据处理和异常处理逻辑。
6. Python 项目配置管理
1. 为什么需要配置管理?
假设你正在开发一个调用大模型的 Python 项目。
最直接的写法是:
API_KEY = "sk-xxxxxxxx"
MODEL = "gpt-4.1"
BASE_URL = "https://api.example.com/v1"
代码可以运行,但存在几个问题:
-
API Key 写死在代码里,容易意外提交到 GitHub。
-
切换模型需要修改代码。
-
本地和服务器使用不同配置时,不方便管理。
因此,我们希望把配置与业务代码分离。
这和之前学习 Spring Boot 时使用的 application.yml 有些类似。
2. 练习
1. 第一步:先使用环境变量
在 Linux 学习阶段已经接触过:
export AGENT_NAME=FridayPython 可以通过标准库 os 读取环境变量。
先进入项目目录:
cd ~/python-engineering创建一个 config_demo.py:
import os

agent_name = os.getenv("AGENT_NAME")

print(f"Agent 名称:{agent_name}")
然后执行:
export AGENT_NAME=Friday
.venv/bin/python config_demo.py
预期输出:
Agent 名称:Friday执行:
unset AGENT_NAME
.venv/bin/python config_demo.py
预期输出:
Agent 名称:None这里有一个你需要掌握的方法:
os.getenv("AGENT_NAME")它的作用是读取名为 AGENT_NAME 的环境变量。
如果不存在,默认返回 None。
也可以指定默认值:
os.getenv("AGENT_NAME", "DefaultAgent")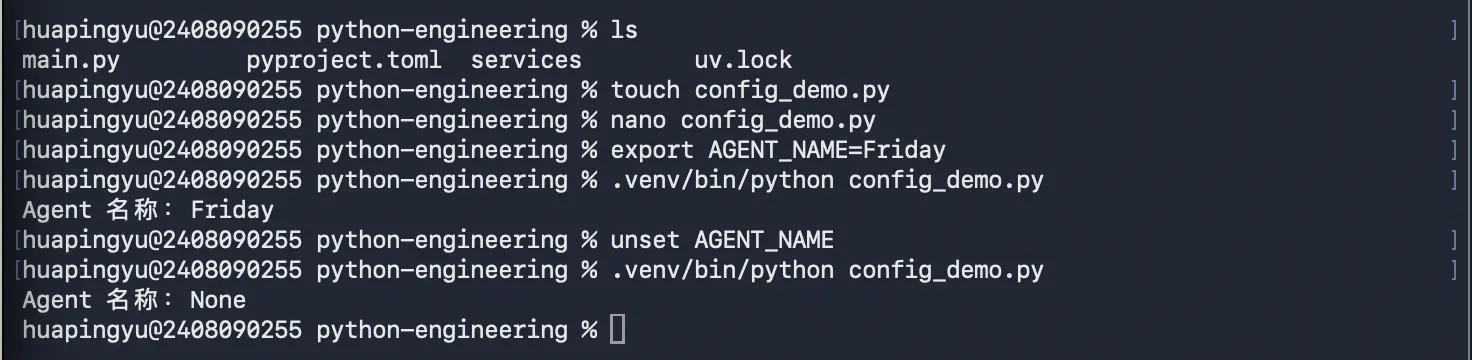
2. 第二步:为什么还需要 .env?
如果项目有十几个配置,每次打开终端都要执行:
export AGENT_NAME=Friday
export MODEL_NAME=gpt-4.1
export API_KEY=xxx
就比较麻烦了。
我们可以创建一个 .env 文件:
AGENT_NAME=Friday
MODEL_NAME=gpt-4.1
API_KEY=your-test-key
但有一个非常重要的区别:
Python 不会自动读取 .env 文件。
os.getenv() 读取的是进程环境变量,而 .env 只是一个普通文本文件。
所以我们需要一个工具,把 .env 中的配置加载进来。
Python 常见的选择是 python-dotenv,后面学习 Pydantic 时,我们还会接触更适合工程项目的配置管理方式。
3. .env 文件管理配置
1. 为什么需要 .env
刚才使用的是:
export AGENT_NAME=Friday这种方式会把变量设置到当前 Shell 环境中,随后启动的 Python 进程可以读取它。
但如果我们有十几个配置,每次都要 export,就比较麻烦。
因此可以把配置集中写进 .env 文件:
AGENT_NAME=Friday
MODEL_NAME=gpt-4.1
API_KEY=your-test-key
然后让 Python 程序读取它们。
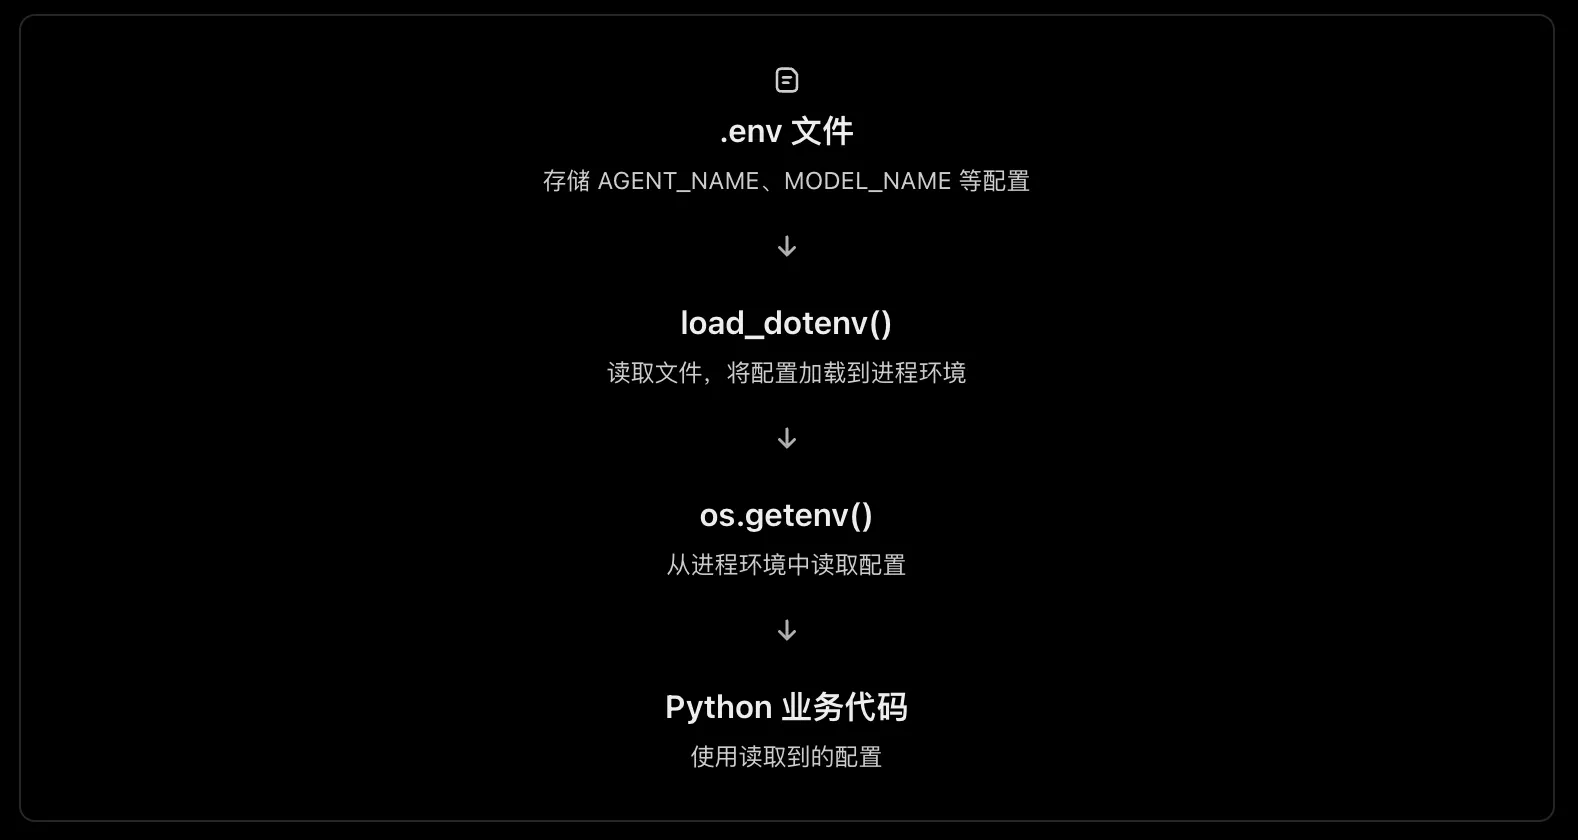
这里要记住一个区别:
-
.env:存储配置的文本文件。 -
os.getenv():读取进程环境变量。 -
python-dotenv:帮助 Python 从.env文件加载配置。
.env 文件本身不会自动变成环境变量。
2. 练习:创建 .env 文件
进入项目目录:
cd ~/python-engineering创建文件:
nano .env写入:
AGENT_NAME=Friday
MODEL_NAME=gpt-4.1
API_KEY=your-test-key
这里的 API Key 只是测试字符串,不需要填写真实密钥。
3. 安装 python-dotenv
你之前已经学习过 uv add,直接使用:
uv add python-dotenv安装成功后,修改 config_demo.py:
import os
from dotenv import load_dotenv

load_dotenv()

agent_name = os.getenv("AGENT_NAME")
model_name = os.getenv("MODEL_NAME")
api_key = os.getenv("API_KEY")

print(f"Agent 名称:{agent_name}")
print(f"模型名称:{model_name}")
print(f"API Key:{api_key}")
这里新增的核心代码只有两行:
from dotenv import load_dotenv

load_dotenv()
load_dotenv() 会查找并读取 .env 文件,将其中的配置加载到进程环境中。默认情况下,它不会覆盖已经存在的环境变量。
4. 运行验证
执行:
.venv/bin/python config_demo.py预期输出:
Agent 名称:Friday
模型名称:gpt-4.1
API Key:your-test-key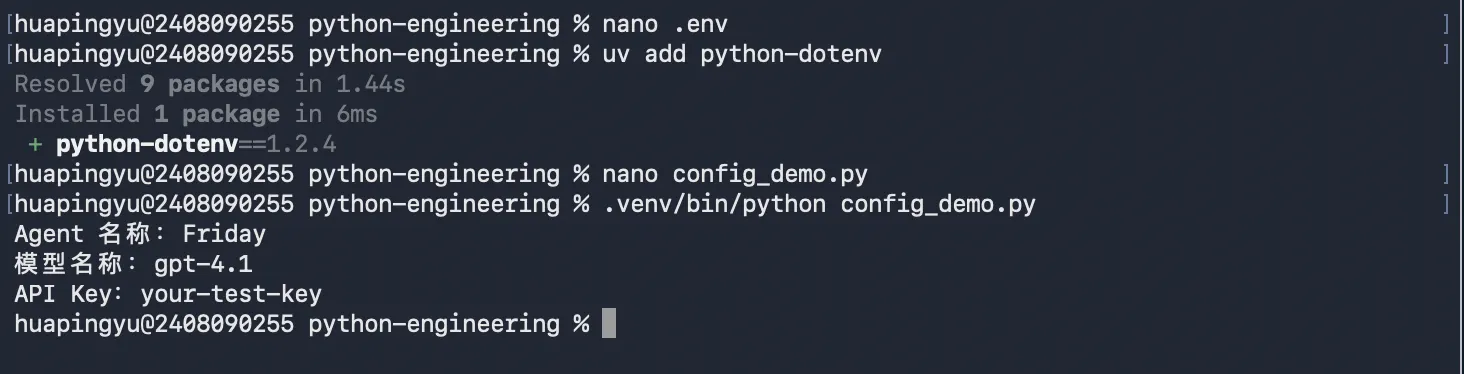
理解整个过程
4. .gitignore 与配置安全
1. 为什么需要 .gitignore?
现在的项目大致是:
python-engineering/
├── .env
├── .venv/
├── main.py
├── config_demo.py
├── services/
├── pyproject.toml
└── uv.lock
其中有些文件适合提交到 GitHub,有些不适合。
| 文件 | 是否提交 Git | 原因 |
|---|---|---|
main.py、services/ |
是 | 项目源代码 |
pyproject.toml |
是 | 声明项目依赖 |
uv.lock |
是 | 锁定依赖版本 |
.env |
否 | 可能包含 API Key 等敏感信息 |
.venv/ |
否 | 本地虚拟环境,可以重新创建 |
.gitignore 的作用就是告诉 Git:哪些尚未被跟踪的文件不需要纳入版本控制。
二、动手创建 .gitignore
确保当前在项目根目录:
cd ~/python-engineering创建并编辑:
nano .gitignore写入以下内容:
# 环境变量与密钥
.env
.env.*

# Python 虚拟环境
.venv/

# Python 缓存
__pycache__/
*.pyc

# macOS
.DS_Store
这里的 .env.* 也会匹配 .env.example。但 .env.example 通常是可以提交的配置模板,所以再加上一行例外:
!.env.example最终保存即可。
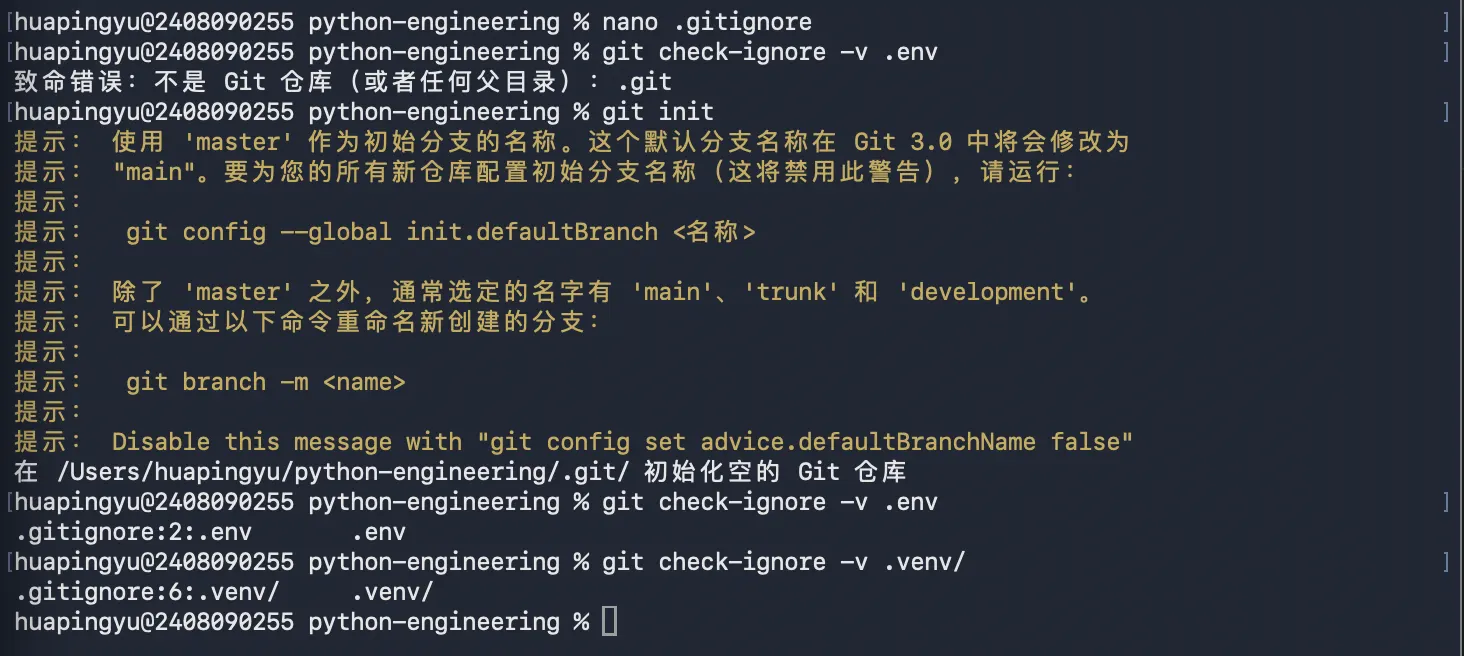
3. 验证规则是否生效
这次不需要创建 Git 仓库,也不需要提交代码。
如果项目已经初始化过 Git,可以执行:
git check-ignore -v .env
git check-ignore -v .venv/
预期会显示对应的 .gitignore 规则。
如果出现:
fatal: not a git repository也没关系,说明当前项目还不是 Git 仓库。
你可以先执行:
git init然后重新运行上面两条检查命令。
注意:如果敏感文件之前已经被 Git 跟踪,后来才加入 .gitignore,它不会自动停止跟踪,更不会清除历史提交中的密钥。
4. 再补充一个实际项目中的习惯
真实项目一般还会创建一个 .env.example:
AGENT_NAME=Friday
MODEL_NAME=gpt-4.1
API_KEY=
这个文件可以提交到 GitHub,让其他开发者知道项目需要哪些配置,但不包含真实密钥。
这样就形成了:
-
.env:本地真实配置,不提交。 -
.env.example:配置模板,可以提交。 -
.gitignore:保护不应提交的文件。
3. HTTP 请求与 requests / httpx
1. 什么是同步请求?
假设你的 AI Agent 需要分别调用三个服务:
-
服务 A:查询天气,需要 2 秒。
-
服务 B:查询新闻,需要 3 秒。
-
服务 C:查询股票,需要 2 秒。
如果采用同步请求,执行过程大致是:
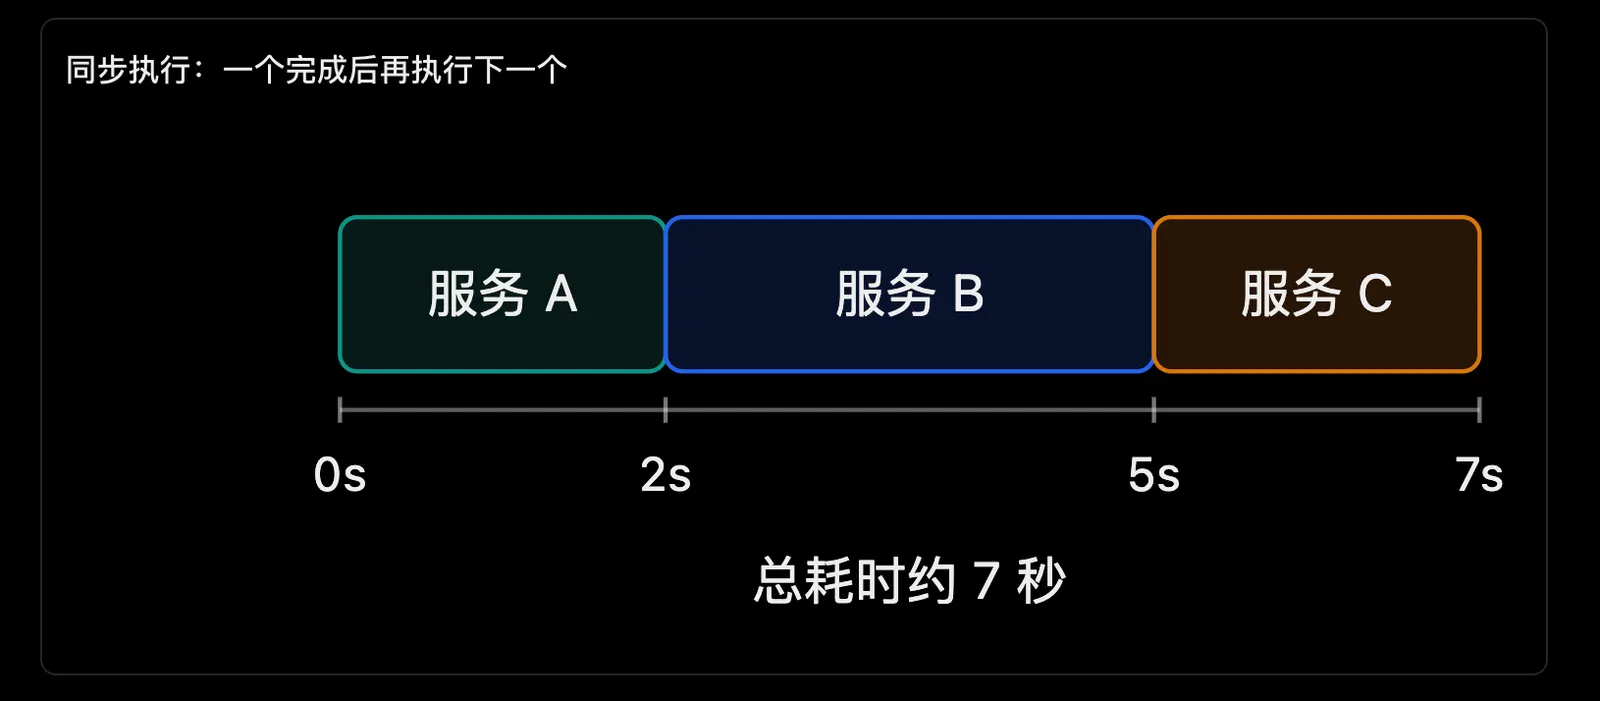
代码类似:
result_a = call_service_a()  # 等待 2 秒
result_b = call_service_b()  # 等待 3 秒
result_c = call_service_c()  # 等待 2 秒
每次调用都需要等待前一次完成。
2. 什么是异步请求?
如果这三个请求相互独立,就可以让它们并发执行。
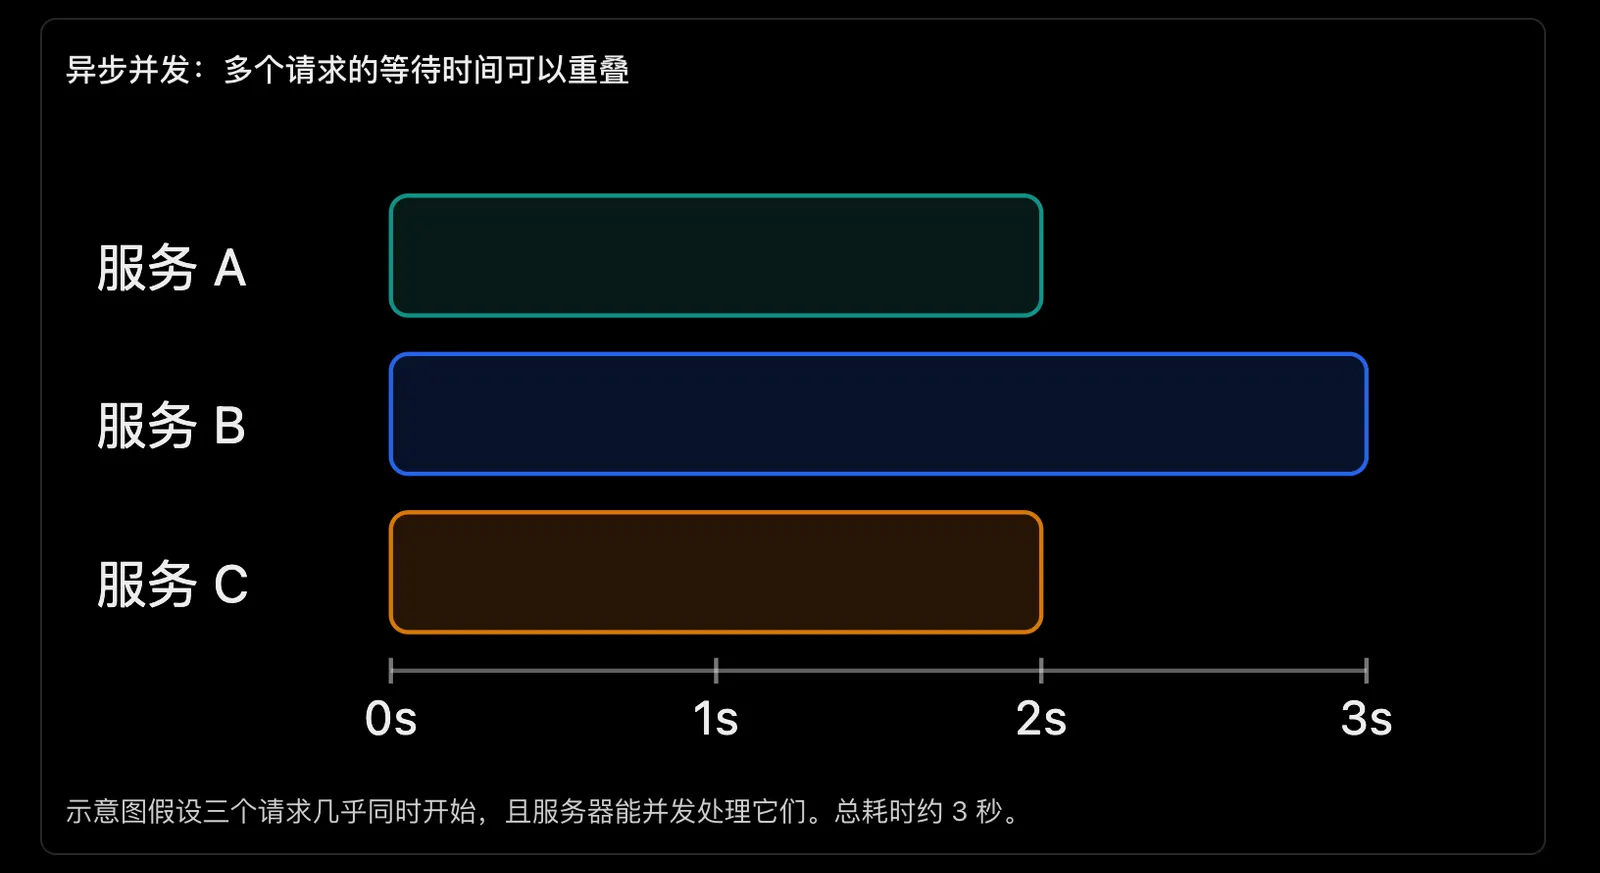
这里要特别注意:
异步不等于三个 Python 函数同时在三个 CPU 核心上执行。
在我们这个场景中,异步的主要价值是:当某个请求正在等待网络响应时,程序可以切换去处理其他请求。
这对于需要同时调用多个外部工具的 AI Agent 很有用。
3. 认识 async 和 await
Python 中的异步函数通常这样定义:
async def fetch_data():
    ...
调用异步操作时,可以使用:
await some_async_operation()先记住:
-
async def:定义异步函数。 -
await:等待异步操作完成,并允许事件循环在等待期间调度其他任务。 -
asyncio.run():从普通同步程序入口运行一个异步协程。
但还有一个容易误解的地方:
只使用 async 和 await,并不代表多个请求就会自动并发。
要实现多个请求并发执行,还需要使用 asyncio.gather() 等工具。
4. 练习:第一次使用 AsyncClient
这次我们先只发送一个异步 HTTP 请求,不急着学习并发。
清空并编辑之前的文件:
truncate -s 0 http_demo.py
nano http_demo.py
写入:
import asyncio
import httpx


async def main():
    async with httpx.AsyncClient(
        base_url="https://httpbin.org",
        timeout=10.0
    ) as client:

        response = await client.get("/get")

        response.raise_for_status()

        print("状态码:", response.status_code)
        print("请求 URL:", response.url)


asyncio.run(main())
运行:
.venv/bin/python http_demo.py预期输出:

5. 和上一关的 Client 有什么区别?
| 同步 Client | 异步 AsyncClient |
|---|---|
with httpx.Client() |
async with httpx.AsyncClient() |
client.get() |
await client.get() |
普通 def 函数 |
async def 函数 |
| 顺序阻塞等待 | 支持非阻塞的异步等待 |
注意,AsyncClient 不是一定比 Client 更快。对于单个 HTTP 请求,两者耗时可能差不多。异步的优势主要体现在多个 I/O 操作可以并发等待。
6. 异步的核心到底是什么
对于现在学习的 Python asyncio,异步的核心是:
一个任务遇到需要等待的操作时,可以暂停自己,让其他任务先执行。等等待条件满足后,再恢复执行。
它并不是简单地让多个任务同时在 CPU 上运行。
1. 异步和并行的区别
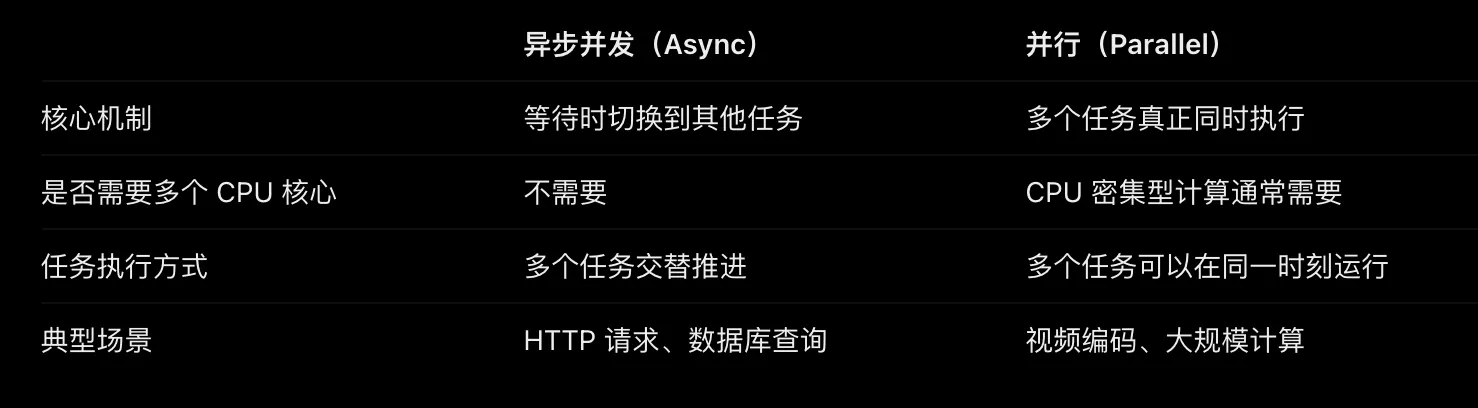
2. 用你熟悉的 Agent 举例
假设一个 Agent 需要调用两个工具:
-
A:调用大模型 API,等待响应 3 秒。
-
B:查询天气 API,等待响应 2 秒。
在单线程 asyncio 中,如果两个任务被安排为并发执行:
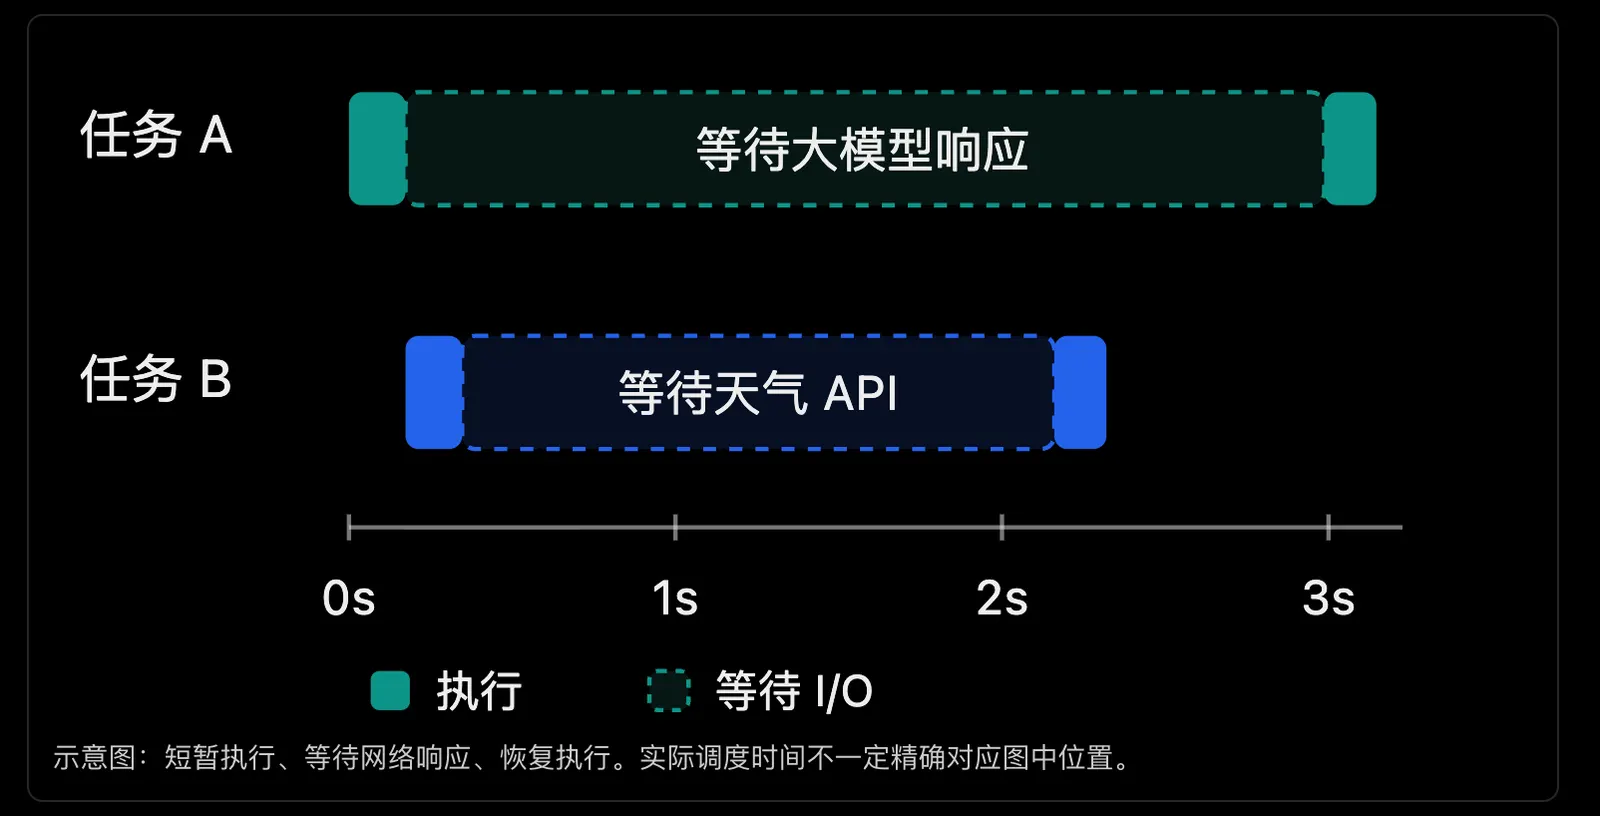
大致执行过程是:
-
任务 A 开始,发送大模型请求。
-
A 遇到
await,需要等待网络响应,于是让出执行机会。 -
事件循环开始执行任务 B,发送天气请求。
-
B 也遇到
await,让出执行机会。 -
天气 API 先返回,B 恢复执行并完成。
-
大模型 API 返回,A 恢复执行并完成。
所以两个任务的等待时间发生了重叠,总耗时大约 3 秒,而不是 5 秒。
3. 那异步是不是跟任务进度有关系?
有关系,但更准确地说,是跟任务能不能主动让出执行机会有关。
Python 的 asyncio 主要采用协作式调度。
例如:
async def task_a():
    await asyncio.sleep(3)
这里任务 A 可以暂停,其他任务就有机会执行。
但如果你写:
async def task_a():
    while True:
        pass
即使加了 async,这个无限循环也没有正常让出执行机会,会一直占用事件循环所在的线程,导致其他协程无法正常推进。
因此:
-
async def不代表自动并发。 -
await是协程可能暂停、让出执行机会的重要位置。 -
asyncio.gather()等机制负责安排多个协程并发执行。 -
事件循环负责在可运行的任务之间进行调度。
一句话总结:异步并发的核心不是多个任务必须同时执行,而是一个任务等待时,其他任务可以继续推进。
7. 练习-对比同步请求和异步并发请求的耗时
1. 练习目标
假设你的 Agent 需要同时调用 3 个外部 API,每个 API 都需要等待约 2 秒。
我们分别使用:
-
同步请求:
httpx.Client -
异步并发请求:
httpx.AsyncClient+asyncio.gather()
理论耗时:
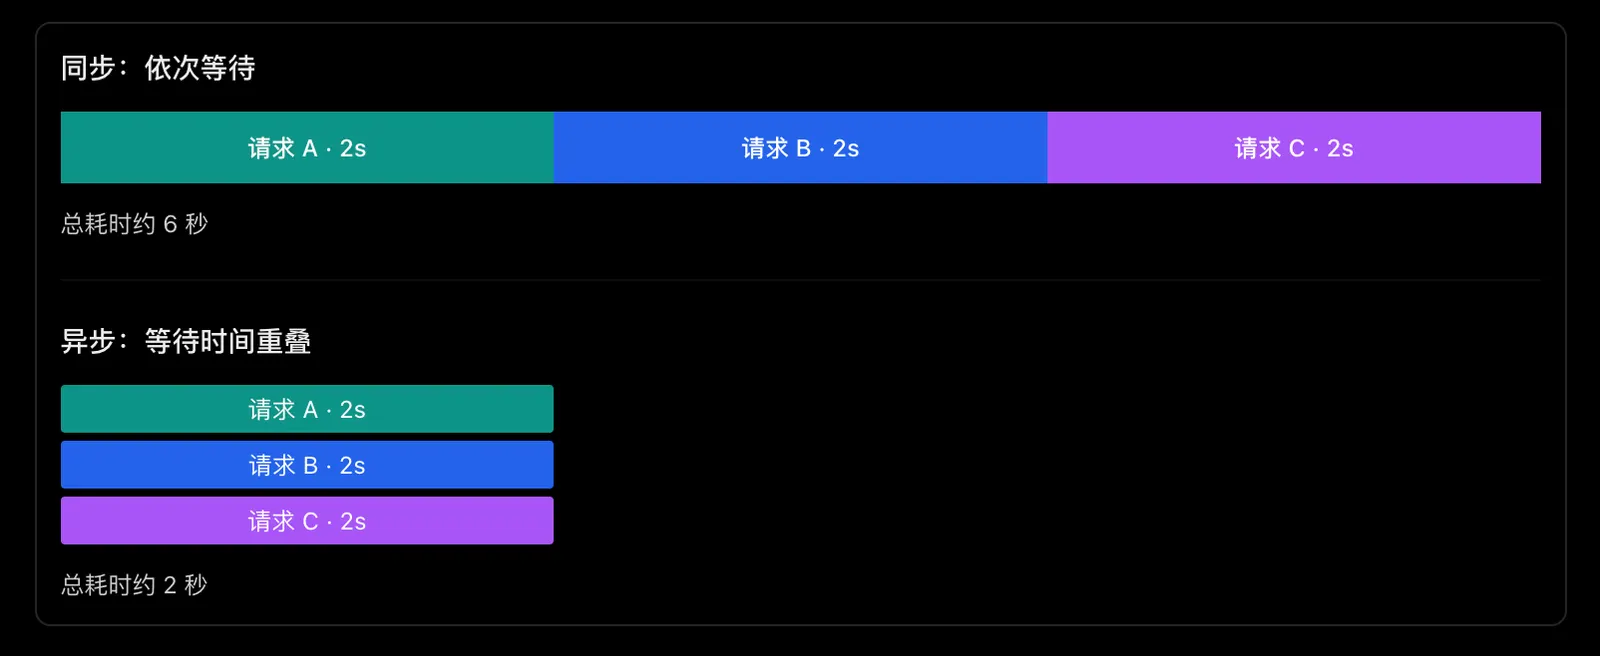
2. 创建练习文件
在你的 ~/python-engineering 项目目录中执行:
cd ~/python-engineering
nano async_http_demo.py
将下面的完整代码复制进去:
import asyncio
import time

import httpx

URL = "https://httpbin.org/delay/2"


# 1. 同步请求
def sync_demo():
    print("===== 同步请求 =====")

    start = time.perf_counter()

    with httpx.Client(timeout=15.0) as client:
        for i in range(1, 4):
            response = client.get(URL)
            response.raise_for_status()
            print(f"请求 {i} 完成:{response.status_code}")

    elapsed = time.perf_counter() - start
    print(f"同步总耗时:{elapsed:.2f} 秒")


# 2. 异步请求
async def fetch(client, i):
    response = await client.get(URL)
    response.raise_for_status()

    print(f"请求 {i} 完成:{response.status_code}")


async def async_demo():
    print("\n===== 异步并发请求 =====")

    start = time.perf_counter()

    async with httpx.AsyncClient(timeout=15.0) as client:
        await asyncio.gather(
            fetch(client, 1),
            fetch(client, 2),
            fetch(client, 3)
        )

    elapsed = time.perf_counter() - start
    print(f"异步总耗时:{elapsed:.2f} 秒")


# 3. 程序入口
sync_demo()
asyncio.run(async_demo())
这里用 time.perf_counter() 计算真实耗时。httpbin.org/delay/2 用于模拟需要等待的 HTTP 请求,但公共服务的响应时间可能受到网络、限流或服务器负载影响。
3. 运行程序
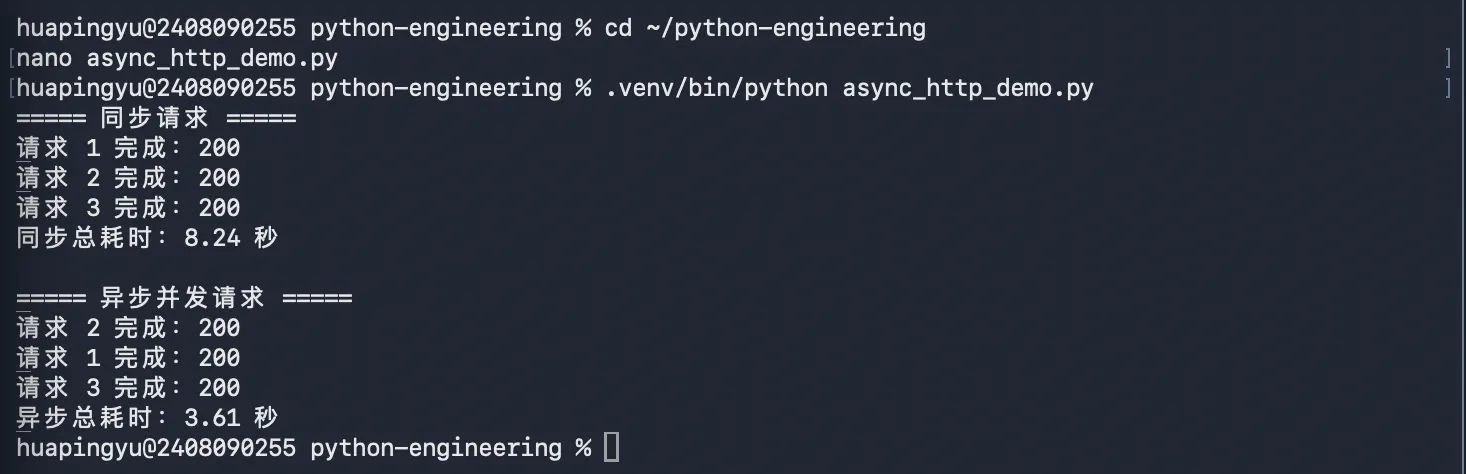
.venv/bin/python async_http_demo.py正常情况下,你会看到类似:
===== 同步请求 =====
请求 1 完成:200
请求 2 完成:200
请求 3 完成:200
同步总耗时:6.80 秒

===== 异步并发请求 =====
请求 1 完成:200
请求 3 完成:200
请求 2 完成:200
异步总耗时:2.60 秒
以上数字只是示例,实际耗时可能不同;异步请求的完成顺序也不固定。
4. Pydantic 数据建模与校验
这一阶段的目标是:能够使用 Pydantic 定义数据结构,自动校验外部数据,并将其应用到后续的 FastAPI 和 Agent 项目中。
1. Pydantic 是什么?
你之前学过 Java,可以把 Pydantic 的 BaseModel 暂时理解成:
Java 的 DTO + 数据类型校验 + 数据解析。
例如,我们开发一个 AI Agent 接口,需要接收用户发送的数据:
{
  "message": "你好",
  "temperature": 0.7,
  "max_tokens": 1000
}
如果只使用 Python 字典:
data = {
    "message": "你好",
    "temperature": 0.7,
    "max_tokens": 1000
}
Python 并不会自动确保这些字段的类型正确,也不会自动判断 temperature 是否在合法范围内。
Pydantic 就是用来解决这类问题的。
2. 先学习最核心的 BaseModel
我们先只学习三个知识点:
-
BaseModel:定义数据模型。 -
字段类型:
str、int、float等。 -
ValidationError:数据校验失败时的异常。
第一步:安装 Pydantic
进入之前的项目目录:
cd ~/python-engineering
uv add pydantic
我们继续使用已经建立好的 uv 项目环境。
第二步:创建练习文件
nano pydantic_demo.py输入以下代码:
from pydantic import BaseModel, ValidationError

class AgentRequest(BaseModel):
    message: str
    temperature: float
    max_tokens: int

# 正常数据
data = {
    "message": "你好",
    "temperature": 0.7,
    "max_tokens": 1000
}

try:
    request = AgentRequest(**data)

    print("模型对象:", request)
    print("用户消息:", request.message)
    print("温度参数:", request.temperature)
    print("最大 Token:", request.max_tokens)

except ValidationError as e:
    print("数据校验失败:")
    print(e)
运行:
.venv/bin/python pydantic_demo.py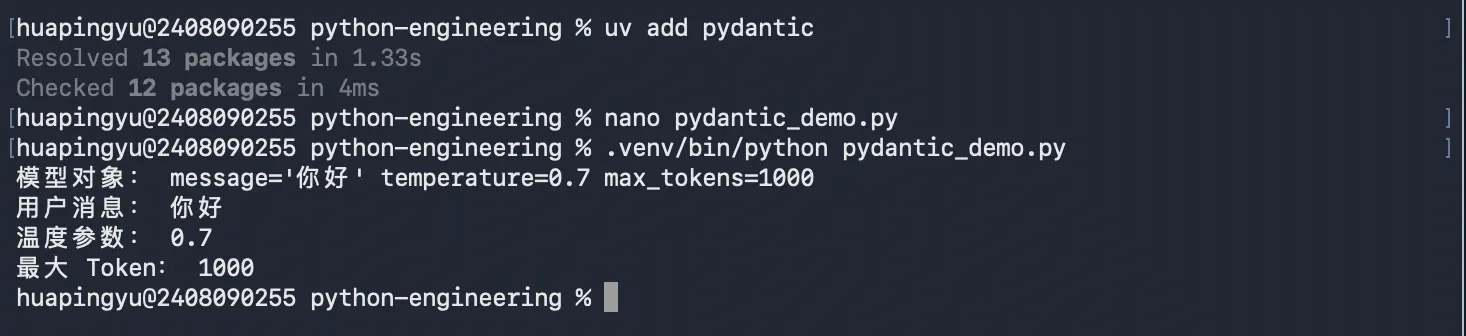
三、理解代码中的两个关键点
① class AgentRequest(BaseModel)
class AgentRequest(BaseModel):
    message: str
    temperature: float
    max_tokens: int
这里定义了一个 Pydantic 数据模型。
message: str 表示我们希望 message 是字符串,temperature: float 表示希望它是浮点数。
Pydantic 会在创建模型实例时进行校验,必要时还会尝试进行类型转换。
② AgentRequest(**data)
request = AgentRequest(**data)这里的 ** 是 Python 的字典解包语法。
它相当于:
request = AgentRequest(
    message="你好",
    temperature=0.7,
    max_tokens=1000
)
也就是将字典中的键值对作为关键字参数传入。
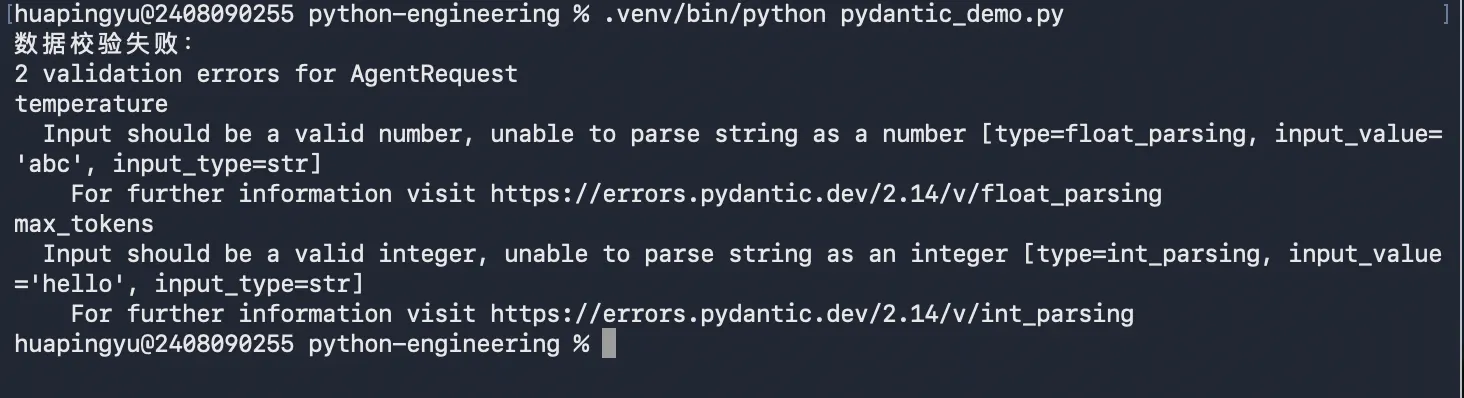
3. 动手练习:故意传入错误数据
第一次成功运行后,把 data 修改为:
data = {
    "message": "你好",
    "temperature": "abc",
    "max_tokens": "hello"
}
再运行一次,观察 ValidationError 输出。
4. Field() 字段约束与默认值
现在考虑一个新问题。
你之前定义的是:
class AgentRequest(BaseModel):
    message: str
    temperature: float
    max_tokens: int
假设用户传入:
data = {
    "message": "",
    "temperature": 100,
    "max_tokens": -50
}
这些数据的类型全部正确,但是对于一个 AI Agent 请求来说,显然不合理。
因此我们不仅要校验类型,还要校验数值范围、字符串长度。
这就需要 Field()。
5. 练习
第一步:修改模型
继续编辑 pydantic_demo.py,替换为以下代码:
from pydantic import BaseModel, Field, ValidationError


class AgentRequest(BaseModel):
    message: str = Field(min_length=1)
    temperature: float = Field(default=0.7, ge=0, le=2)
    max_tokens: int = Field(default=1000, gt=0, le=4096)


data = {
    "message": "你好"
}

try:
    request = AgentRequest(**data)
    print("模型对象:", request)

except ValidationError as e:
    print("数据校验失败:")
    print(e)
这段代码引入了几个新参数:
| 参数 | 含义 | 示例 |
|---|---|---|
default |
默认值 | default=0.7 |
min_length |
最小字符串长度 | min_length=1 |
ge |
大于等于 | ge=0 |
gt |
大于 | gt=0 |
le |
小于等于 | le=2 |
这里的 temperature 允许范围是 0~2,max_tokens 允许范围是 1~4096。这些是我们为练习设定的规则,不代表所有大模型 API 都采用相同限制。
第二步:运行
.venv/bin/python pydantic_demo.py
注意:我们没有传入 temperature 和 max_tokens,但 Pydantic 自动使用了默认值。
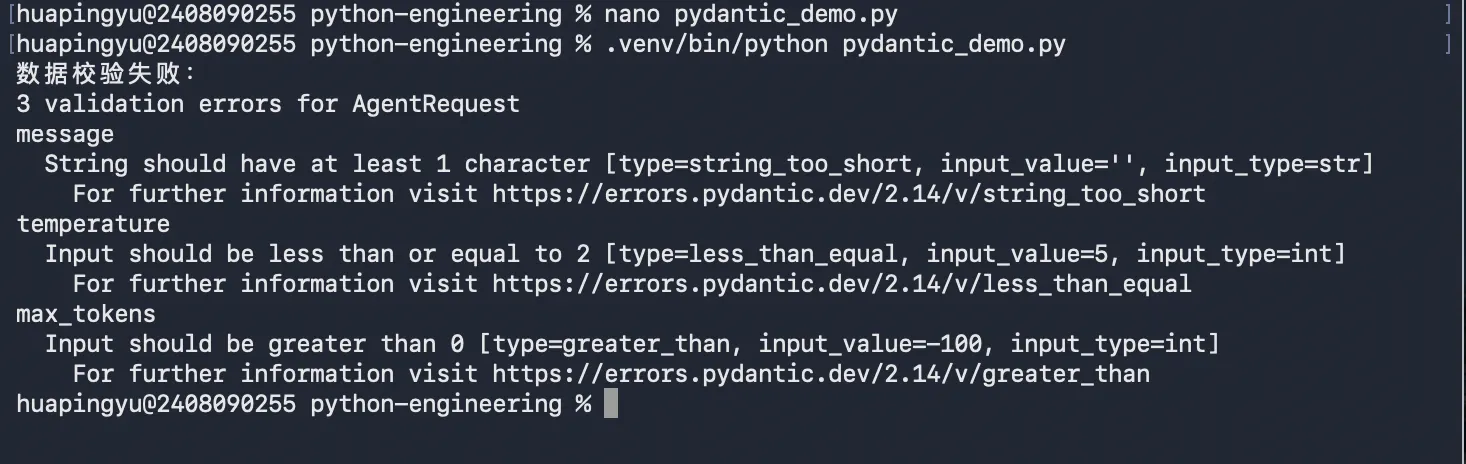
第三步:测试非法数据
将 data 修改为:
data = {
    "message": "",
    "temperature": 5,
    "max_tokens": -100
}
重新运行,观察三个字段分别出现什么错误。
6. 嵌套模型
1. 什么是嵌套模型?
假设我们开发一个 Agent,它接收的请求不再只有一条消息,而是包含用户信息和聊天记录:
{
  "user": {
    "id": 1,
    "name": "张三"
  },
  "messages": [
    {
      "role": "user",
      "content": "你好"
    },
    {
      "role": "assistant",
      "content": "你好,有什么可以帮你?"
    }
  ]
}
这里出现了两个特点:
-
user是一个嵌套对象。 -
messages是一个列表,里面包含多个对象。
Pydantic 可以让我们分别定义这些数据结构,再组合成完整模型。
2. 动手实现
创建新文件,保留之前的练习代码:
nano pydantic_nested.py输入:
from pydantic import BaseModel, Field


class User(BaseModel):
    id: int
    name: str


class Message(BaseModel):
    role: str
    content: str = Field(min_length=1)


class ChatRequest(BaseModel):
    user: User
    messages: list[Message]


data = {
    "user": {
        "id": 1,
        "name": "张三"
    },
    "messages": [
        {
            "role": "user",
            "content": "你好"
        },
        {
            "role": "assistant",
            "content": "你好,有什么可以帮你?"
        }
    ]
}


request = ChatRequest(**data)

print("用户姓名:", request.user.name)
print("第一条消息:", request.messages[0].content)
print("消息数量:", len(request.messages))
print("完整数据:", request.model_dump())
运行:
.venv/bin/python pydantic_nested.py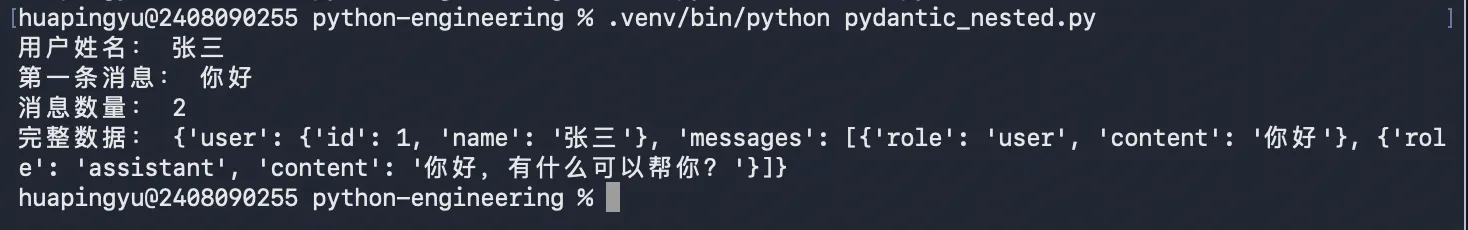
3. 理解三个关键知识点
① 模型可以作为另一个模型的字段类型
class ChatRequest(BaseModel):
    user: User
这表示 user 必须符合 User 模型的结构。
② list[Message] 表示列表中的每个元素都必须符合 Message 模型
messages: list[Message]Pydantic 会逐个校验列表中的消息。
③ model_dump() 将模型转换为 Python 字典
request.model_dump()它会将嵌套模型也转换成字典和列表,方便后续处理。
如果需要 JSON 字符串,则可以使用:
request.model_dump_json()7. 数据转换
-
序列化:将模型对象转换成字典、JSON 等便于传输或存储的数据。
-
反序列化:将 JSON 等数据解析为程序中的对象。在 Pydantic 中,这个过程通常还包含数据校验。
1. 三个常用方法
| 方法 | 作用 | 返回结果 |
|---|---|---|
model_dump() |
模型转字典 | dict |
model_dump_json() |
模型转 JSON 字符串 | str |
model_validate() |
从字典等数据校验并创建模型 | BaseModel 实例 |
2. 直接动手
在 ~/python-engineering 中创建:
nano pydantic_serialization.py复制以下代码:
from pydantic import BaseModel

class AgentRequest(BaseModel):
    message: str
    temperature: float = 0.7

# 1. 创建模型对象
request = AgentRequest(message="你好")

# 2. 序列化为字典
data = request.model_dump()
print("字典:", data)
print("类型:", type(data))

# 3. 序列化为 JSON 字符串
json_data = request.model_dump_json()
print("JSON:", json_data)
print("类型:", type(json_data))

# 4. 从字典重新创建模型
new_request = AgentRequest.model_validate(data)
print("重新创建:", new_request)
print("类型:", type(new_request))
运行:
.venv/bin/python pydantic_serialization.py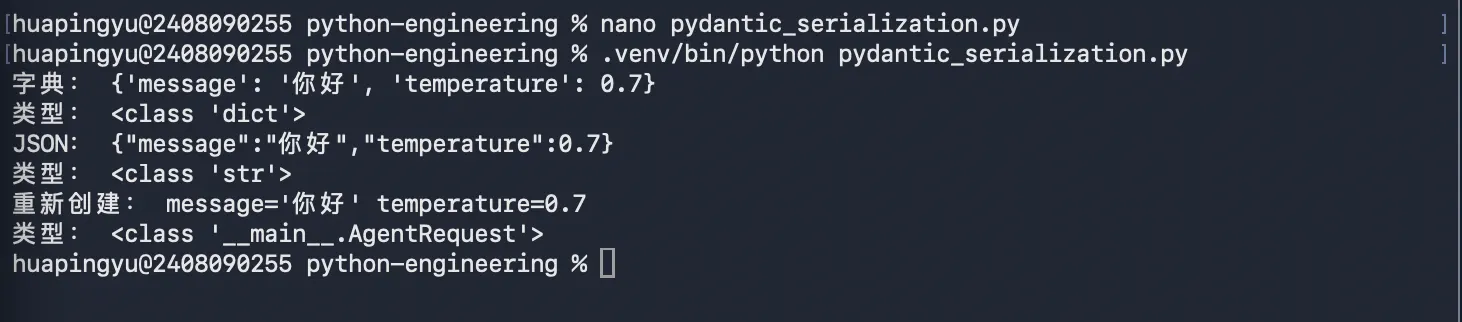
5. FastAPI Web 开发
1. FastAPI 入门与项目启动
目标:使用 FastAPI 启动 Web 服务,并成功访问自己编写的 HTTP 接口。
1. FastAPI 和 Uvicorn 分别是什么?
-
FastAPI:Python Web 框架,负责定义路由、处理请求、返回响应。
-
Uvicorn:ASGI 服务器,负责监听端口、接收 HTTP 请求,并运行 FastAPI 应用。
可以简单类比:
| Java / Spring Boot | Python / FastAPI |
|---|---|
| Spring Boot | FastAPI |
| 内嵌 Tomcat | Uvicorn |
@GetMapping |
@app.get() |
2. 安装依赖
继续使用之前的项目:
cd ~/python-engineering
uv add fastapi uvicorn
安装完成后,我们不需要重新创建虚拟环境。
3. 编写第一个 FastAPI 应用
创建文件:
nano fastapi_demo.py复制以下代码:
from fastapi import FastAPI

app = FastAPI()


@app.get("/hello")
def hello():
    return {"message": "Hello FastAPI!"}


@app.get("/health")
def health():
    return {"status": "ok"}
这里重点理解三行:
① app = FastAPI()
创建 FastAPI 应用实例,类似 Spring Boot 中的 Web 应用。
② @app.get("/hello")
注册 GET 请求路由。
当客户端访问 /hello 时,FastAPI 就会调用下面的 hello() 函数。
③ return {"message": "Hello FastAPI!"}
返回 Python 字典,FastAPI 会自动将其转换成 JSON HTTP 响应。
4. 启动服务
在项目目录执行:
.venv/bin/uvicorn fastapi_demo:app --reload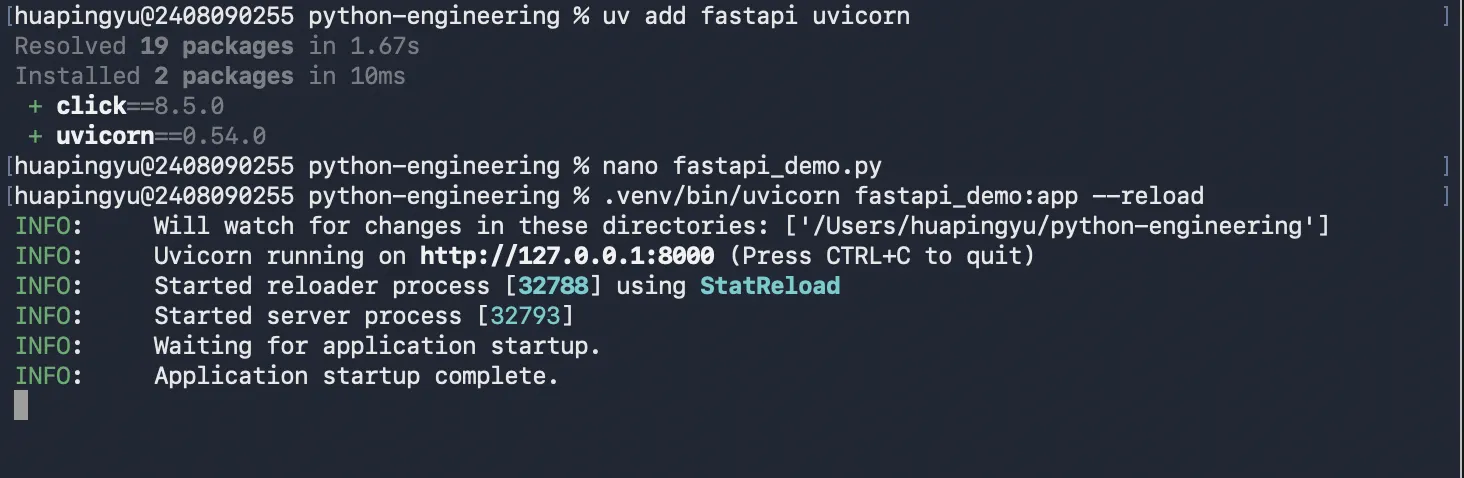
其中:
-
fastapi_demo:Python 文件名,不带.py。 -
app:文件中的app = FastAPI()对象。 -
--reload:检测到代码变化时自动重启服务,适合开发环境。
默认监听 127.0.0.1:8000。
注意:启动后终端会持续运行,这是正常现象,不要关闭它。
5. 测试接口
打开浏览器,分别访问:
http://127.0.0.1:8000/hello
http://127.0.0.1:8000/health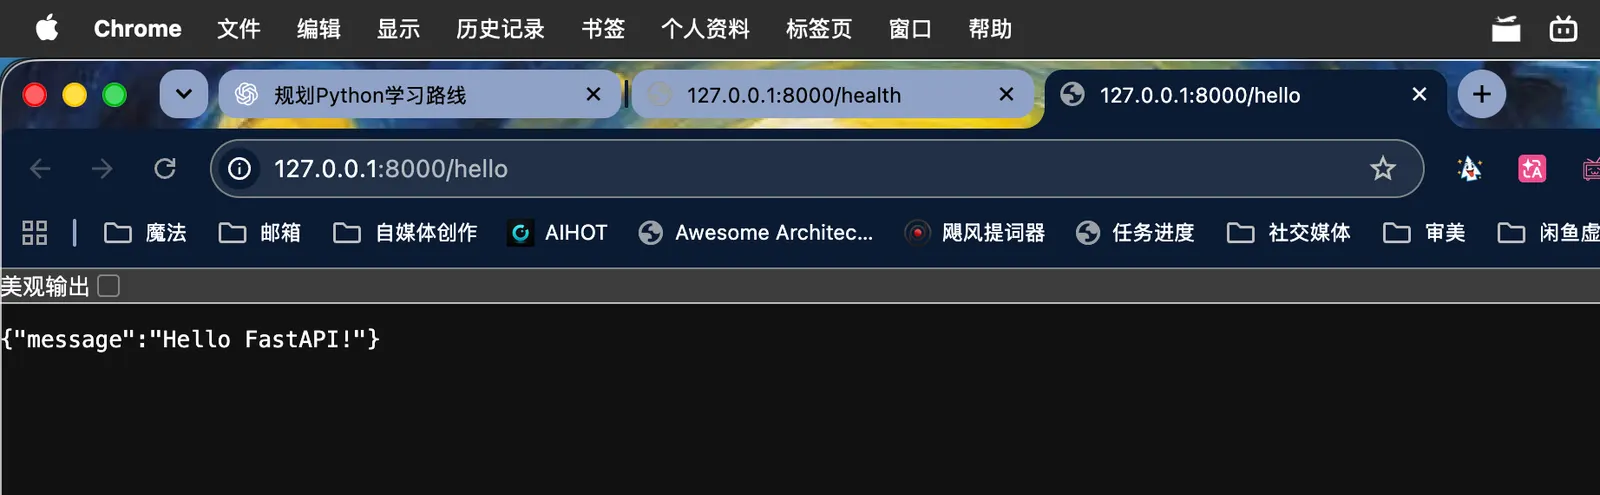
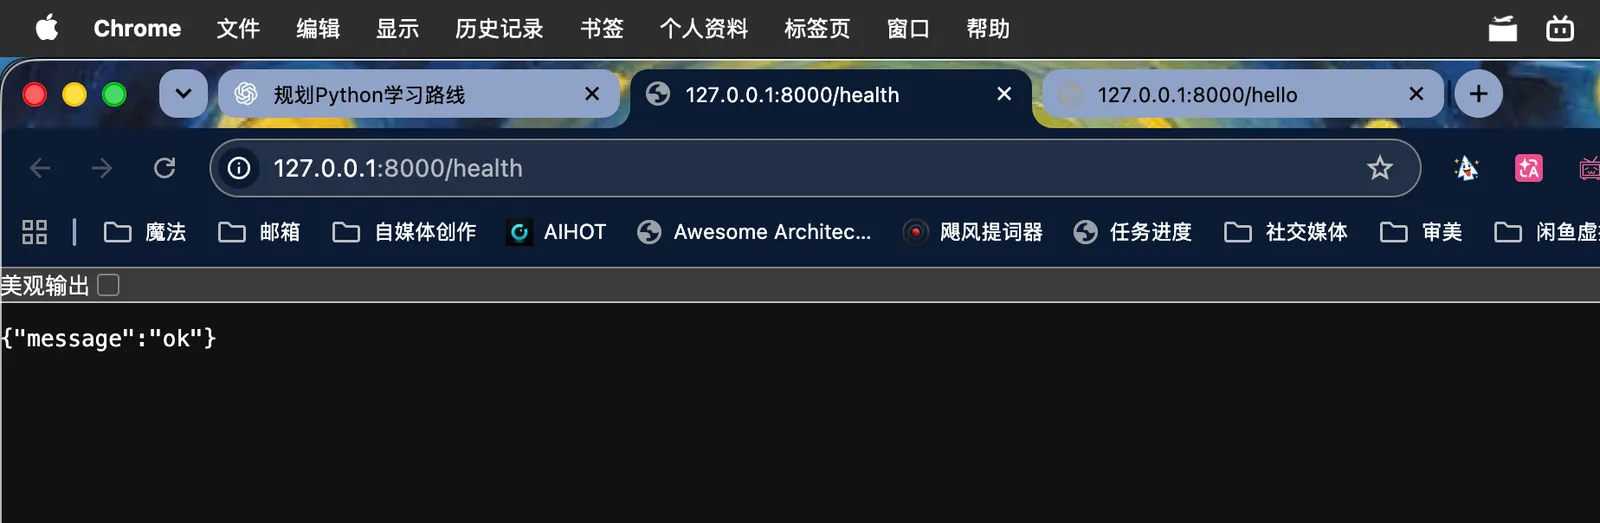
http://127.0.0.1:8000/docs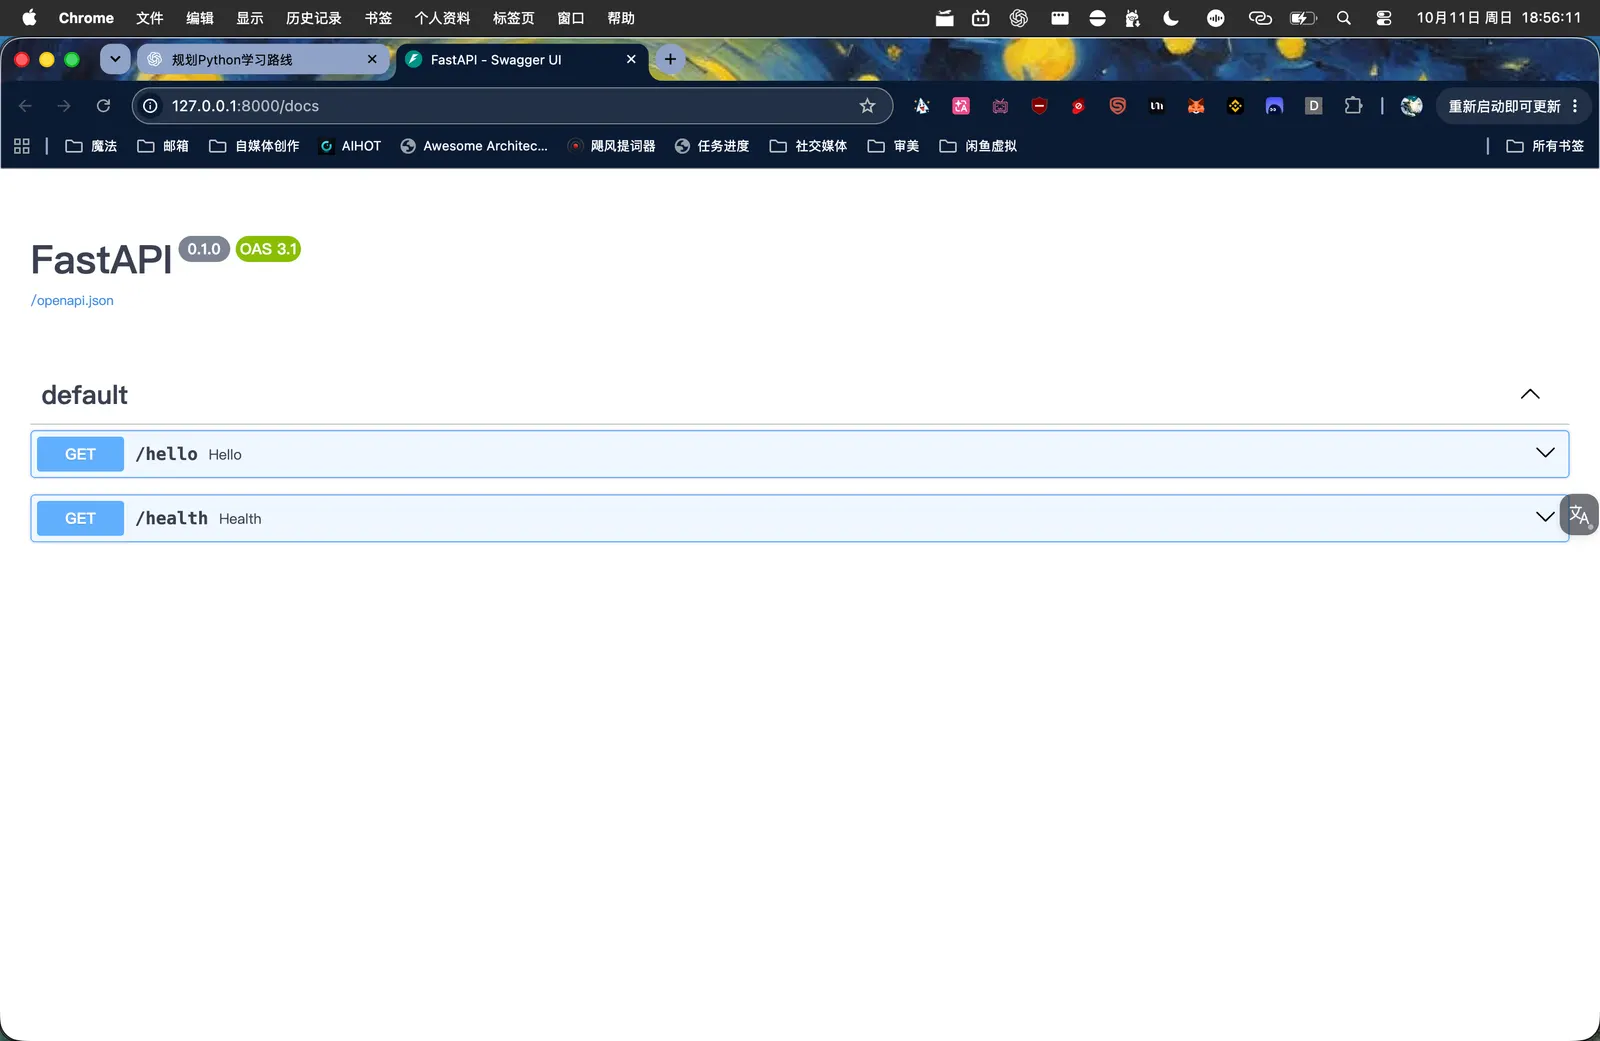
你也可以新开一个终端窗口,通过 curl 测试:
curl http://127.0.0.1:8000/hello2. 路由与请求参数
1. 路径参数-Path Parameters
假设我们要根据用户 ID 查询用户信息。
请求地址:
GET /users/1001在 FastAPI 中:
@app.get("/users/{user_id}")
def get_user(user_id: int):
    return {
        "user_id": user_id,
        "name": "张三"
    }
这里的 {user_id} 是路径参数。
当你访问:
http://127.0.0.1:8000/users/1001
FastAPI 会自动把路径中的 1001 解析为整数,并传给 get_user()。
对应 Spring Boot:
@GetMapping("/users/{userId}")
public Object getUser(@PathVariable Integer userId) {
    // ...
}
FastAPI 不需要额外写 @PathVariable。
2. 查询参数-Query Parameters
假设我们要查询用户列表,并支持分页。
请求地址:
GET /users?page=1&size=10FastAPI 代码:
@app.get("/users")
def list_users(page: int = 1, size: int = 10):
    return {
        "page": page,
        "size": size
    }
这里:
-
page默认值是 1。 -
size默认值是 10。 -
FastAPI 自动从 URL 查询字符串中读取参数。
对应 Spring Boot 中的 @RequestParam。
3. POST 请求体-Request Body
这里就能用到我们刚学过的 Pydantic。
from pydantic import BaseModel

class ChatRequest(BaseModel):
    message: str
    temperature: float = 0.7

@app.post("/chat")
def chat(request: ChatRequest):
    return {
        "reply": f"收到消息:{request.message}",
        "temperature": request.temperature
    }
客户端发送:
POST /chat
Content-Type: application/json
请求体:
{
  "message": "你好,Agent",
  "temperature": 0.8
}
FastAPI 会自动将 JSON 请求体解析、校验为 ChatRequest 对象。
这和 Spring Boot 的 @RequestBody + DTO 很相似。
4. 动手练习
现在打开你之前的文件:
nano fastapi_demo.py保留原来的三个接口,在文件顶部添加:
from pydantic import BaseModel然后在文件末尾添加以下代码:
# 1. 路径参数
@app.get("/users/{user_id}")
def get_user(user_id: int):
    return {
        "user_id": user_id,
        "name": "张三"
    }

# 2. 查询参数
@app.get("/users")
def list_users(page: int = 1, size: int = 10):
    return {
        "page": page,
        "size": size
    }


# 3. POST 请求体
class ChatRequest(BaseModel):
    message: str
    temperature: float = 0.7

@app.post("/chat")
def chat(request: ChatRequest):
    return {
        "reply": f"收到消息:{request.message}",
        "temperature": request.temperature
    }
保存后,Uvicorn 会自动重新加载。
5. 测试三个接口
.venv/bin/uvicorn fastapi_demo:app --reload测试 1:路径参数
curl http://127.0.0.1:8000/users/1001预期:
{"user_id":1001,"name":"张三"}测试 2:查询参数
curl "http://127.0.0.1:8000/users?page=2&size=5"预期:
{"page":2,"size":5}测试 3:POST 请求体
curl -X POST http://127.0.0.1:8000/chat \
  -H "Content-Type: application/json" \
  -d '{"message":"你好,Agent","temperature":0.8}'
预期:
{"reply":"收到消息:你好,Agent","temperature":0.8}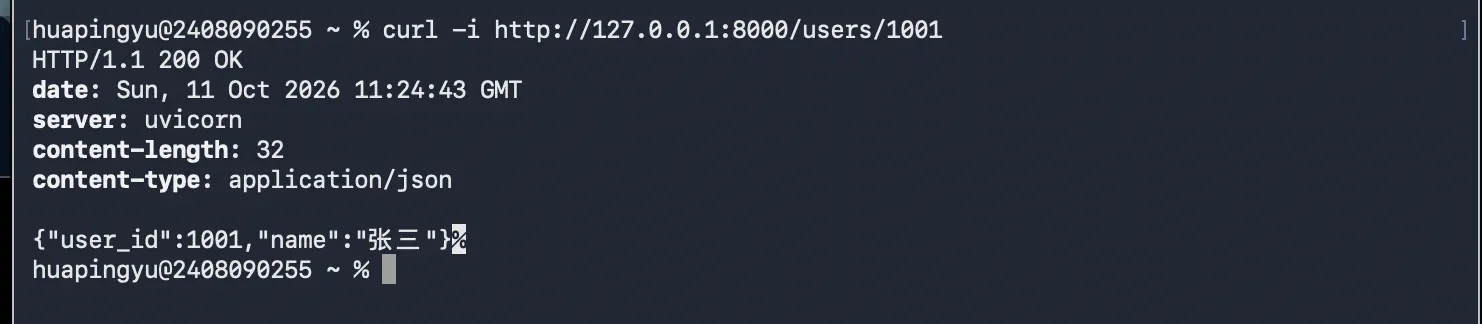
6. 留一个真正的排错练习
完成三个正常请求后,再执行:
curl http://127.0.0.1:8000/users/abc思考:为什么这个请求会失败?FastAPI 会返回什么 HTTP 状态码?
这次不要只回答“因为类型不匹配”,而是结合实际返回结果,判断:
-
错误发生在路由匹配阶段,还是参数校验阶段?
-
get_user()函数有没有真正执行?
说明 FastAPI 已经成功匹配 /users/{user_id} 路由,但发现 abc 无法转换成整数,因此在执行 get_user() 之前就返回了 422。
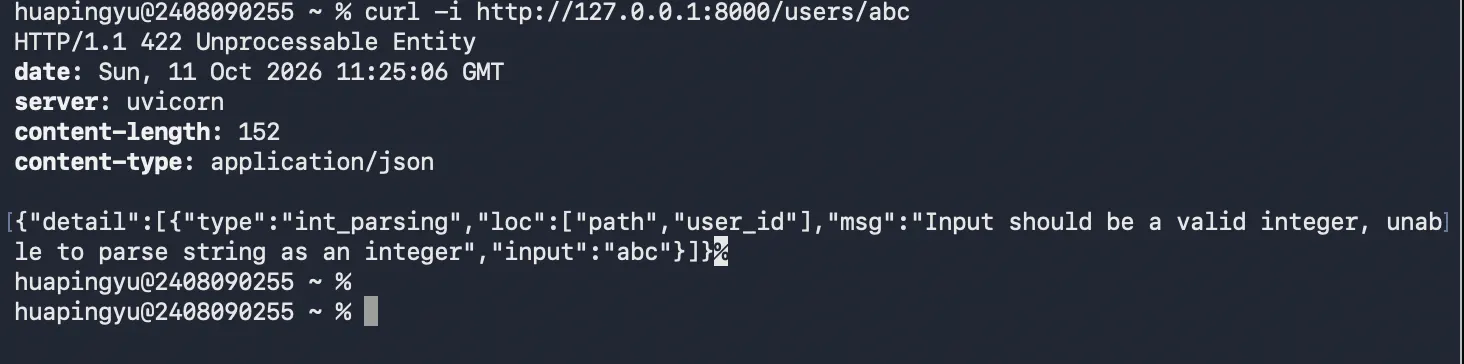
- 422:请求数据未通过校验。
3. Pydantic 请求与响应模型
这次重点补充两个能力:
-
使用
Field()自动校验请求数据。 -
使用
response_model约束接口返回的数据。
1. 添加请求与响应模型
继续编辑:
nano ~/python-engineering/fastapi_demo.py确保文件顶部包含:
from pydantic import BaseModel, Field然后在文件末尾添加:
class AgentChatRequest(BaseModel):
    message: str = Field(min_length=1)
    temperature: float = Field(default=0.7, ge=0, le=2)

class AgentChatResponse(BaseModel):
    reply: str
    model: str

@app.post("/agent/chat", response_model=AgentChatResponse)
def agent_chat(request: AgentChatRequest):
    return {
        "reply": f"Agent 收到:{request.message}",
        "model": "demo-agent",
        "internal_token": "secret-123"
    }
这里有个值得注意的地方:
我们定义的响应模型只有:
class AgentChatResponse(BaseModel):
    reply: str
    model: str
但接口实际返回的字典中,还包含 internal_token。
FastAPI 会根据 response_model 校验和序列化响应,并过滤掉响应模型中未定义的额外字段。
这对于 Agent API 很实用,因为我们可能不希望把内部数据返回给客户端。
2. 测试接口
使用 Swagger UI:
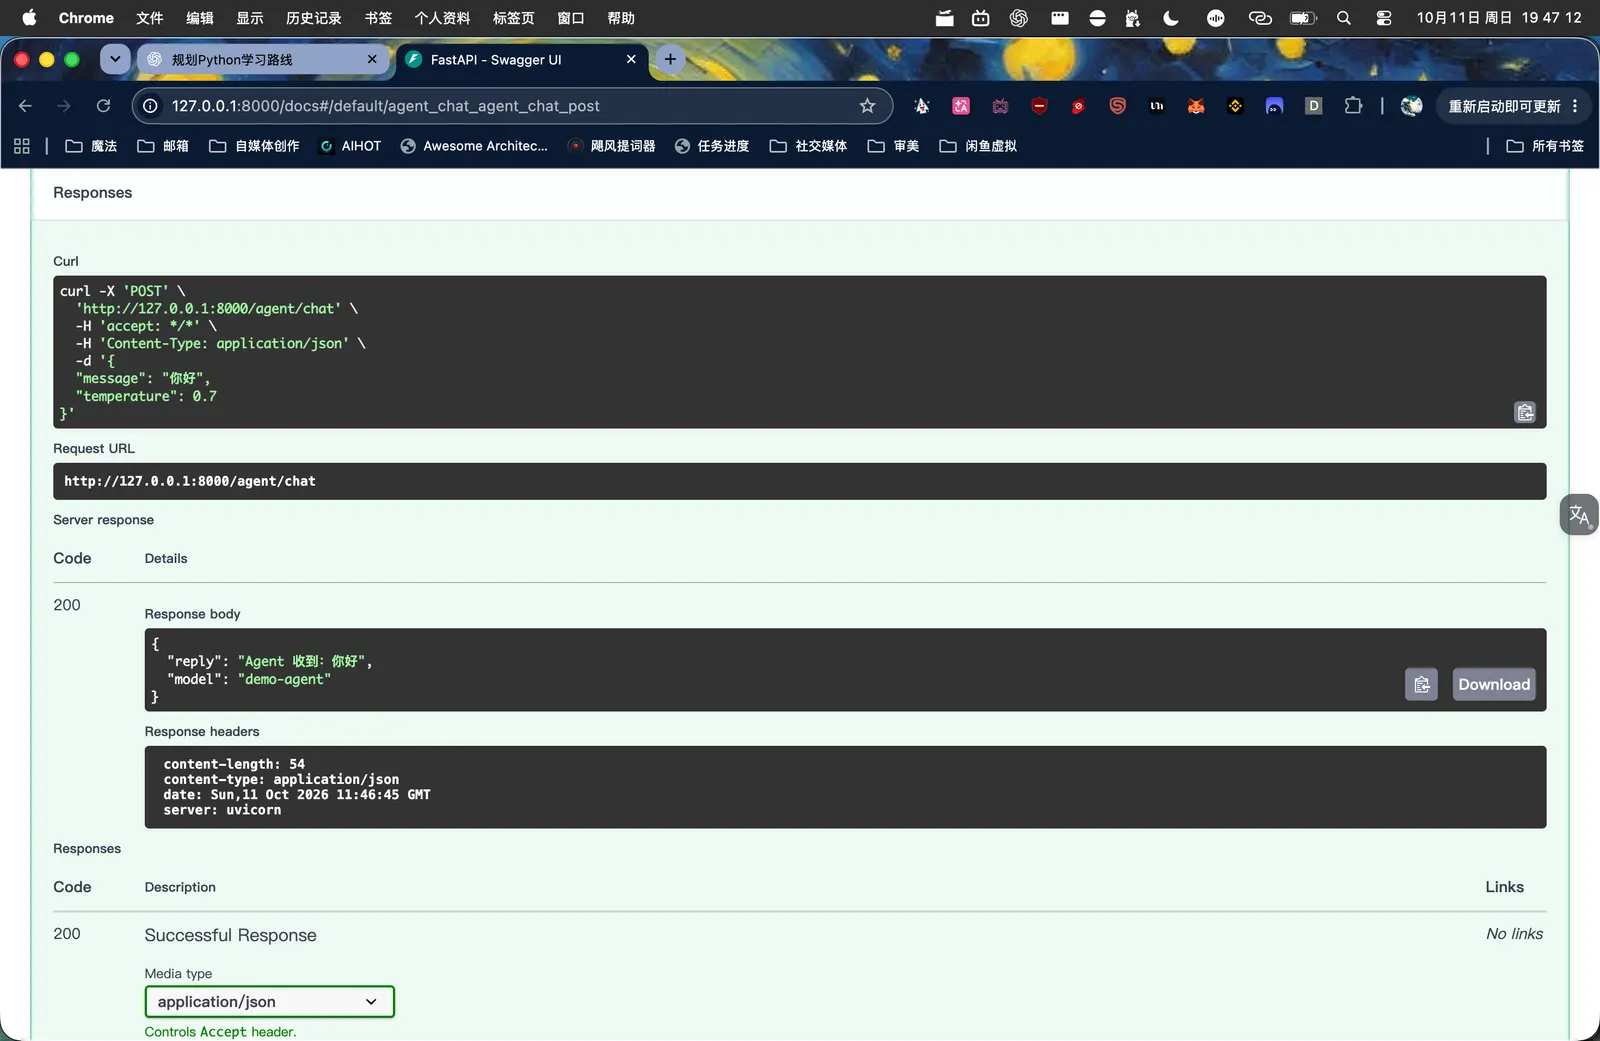
找到 POST /agent/chat,点击 Try it out,提交:
{
  "message": "你好",
  "temperature": 0.7
}
观察返回的 JSON。
3. 测试非法数据
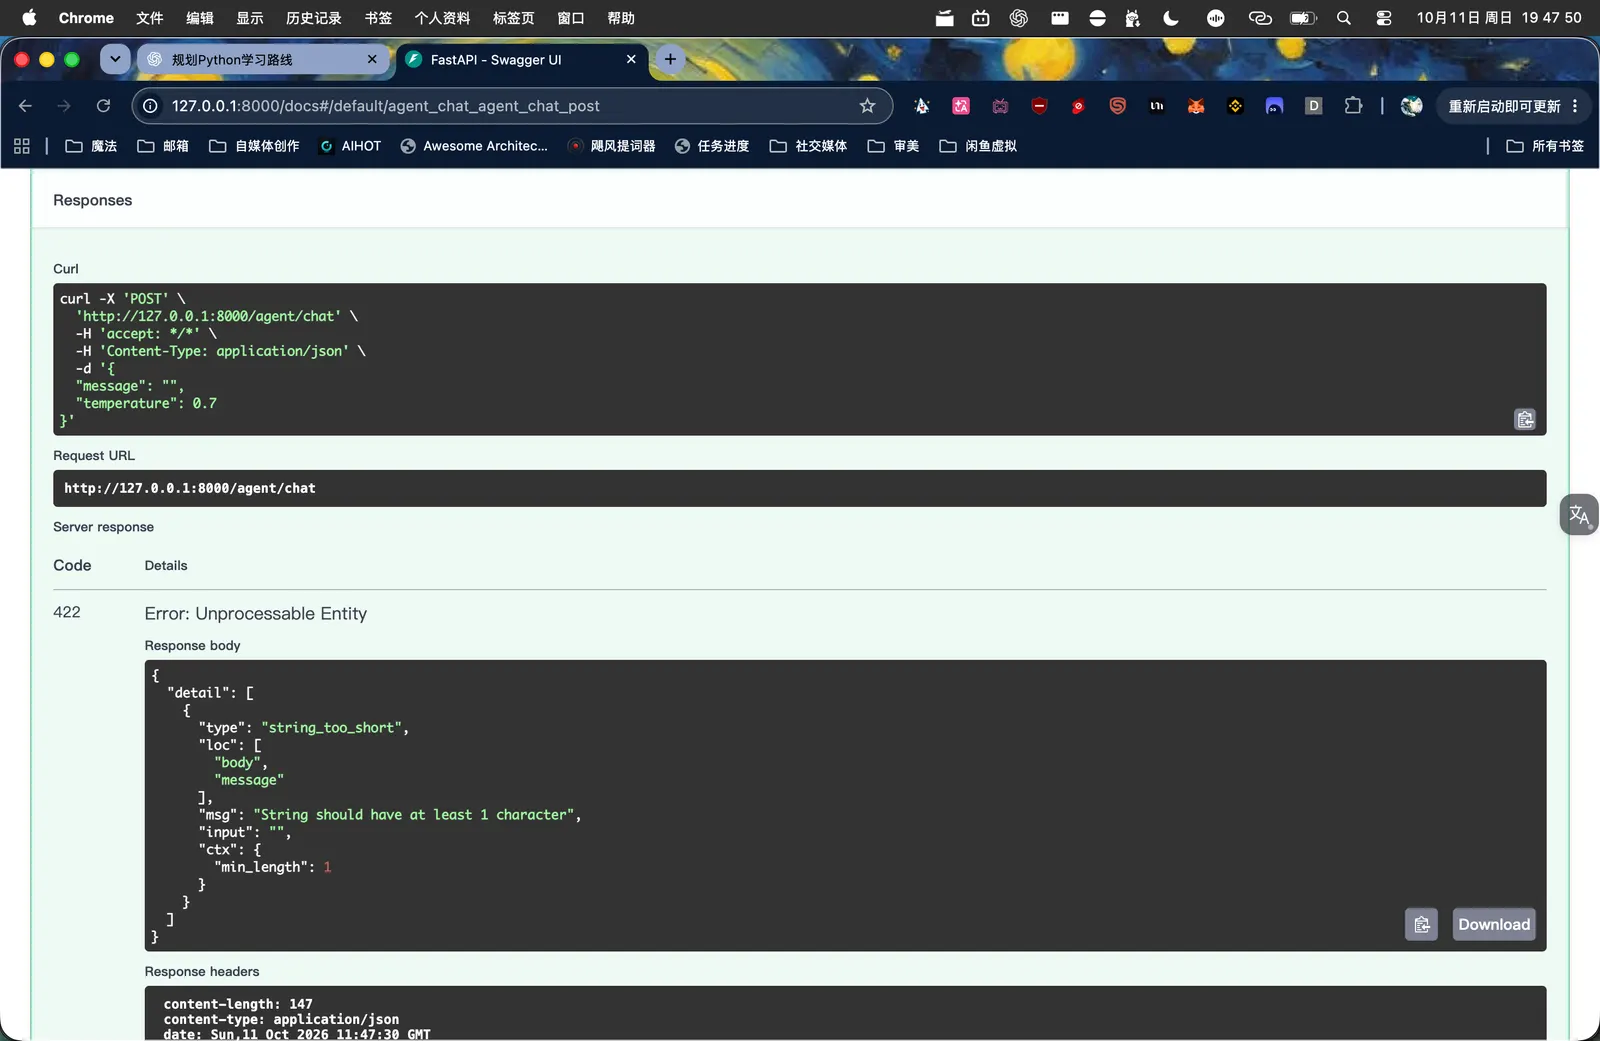
再提交:
{
  "message": "",
  "temperature": 5
}
观察 FastAPI 返回的校验错误。
4. FastAPI 异常处理与 HTTP 状态码
1. 为什么需要「主动」处理异常?
之前你已经遇到过三种状态码:
| 状态码 | 含义 | 常见场景 |
|---|---|---|
| 404 | Not Found | 用户不存在、资源不存在 |
| 422 | Unprocessable Entity | 请求参数校验失败 |
| 500 | Internal Server Error | 服务端出现未处理的异常 |
但是有个问题:
假设用户请求:
GET /users/99999999 是合法整数,FastAPI 的参数校验能够通过。
但数据库中根本不存在这个用户。
这种业务错误,FastAPI 无法自动判断,需要我们自己处理。
2. 认识 HTTPException
FastAPI 提供了 HTTPException,让我们主动返回指定的 HTTP 错误。
例如:
from fastapi import HTTPException

raise HTTPException(
    status_code=404,
    detail="用户不存在"
)
这里:
-
raise:抛出异常。 -
status_code=404:指定 HTTP 状态码。 -
detail:返回给客户端的错误信息。
对应 Spring Boot,可以理解为主动抛出带有 HTTP 状态码的业务异常。
3. 练习:模拟查询用户
我们先不连接数据库,直接使用字典模拟用户数据。
继续编辑:
nano ~/python-engineering/fastapi_demo.py确保顶部已经导入:
from fastapi import FastAPI, HTTPException然后在文件末尾添加:
# 模拟数据库
users_db = {
    1: {"id": 1, "name": "张三"},
    2: {"id": 2, "name": "李四"}
}

@app.get("/users/detail/{user_id}")
def get_user_detail(user_id: int):
    user = users_db.get(user_id)

    if user is None:
        raise HTTPException(
            status_code=404,
            detail="用户不存在"
        )

    return user
这里使用的是 users_db.get(user_id):
-
找到了用户:返回对应字典。
-
没找到用户:返回
None,随后抛出 404 异常。
注意,我们使用 /users/detail/{user_id},避免和前面已有的 /users/{user_id} 路由混淆。
4. 测试三种情况
保持 Uvicorn 服务运行,在另一个终端分别执行:
测试 1:用户存在
curl -i http://127.0.0.1:8000/users/detail/1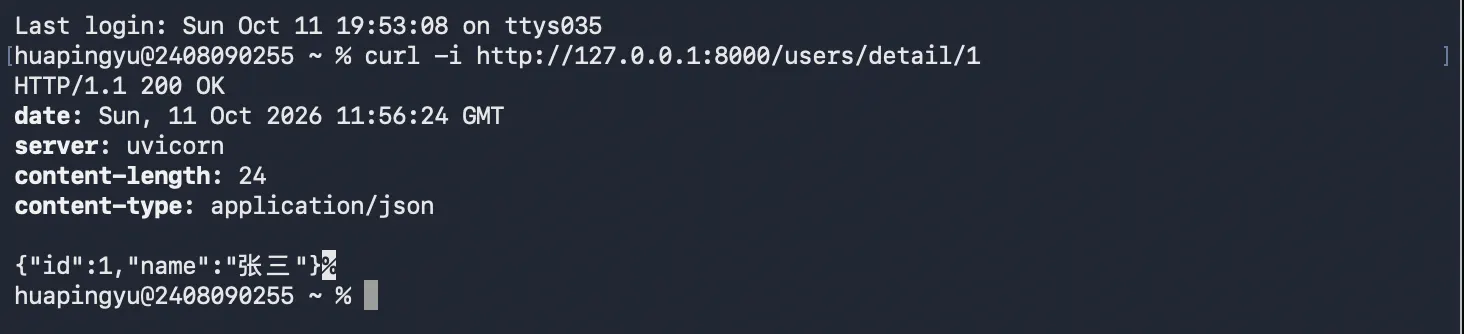
测试 2:用户不存在
curl -i http://127.0.0.1:8000/users/detail/9999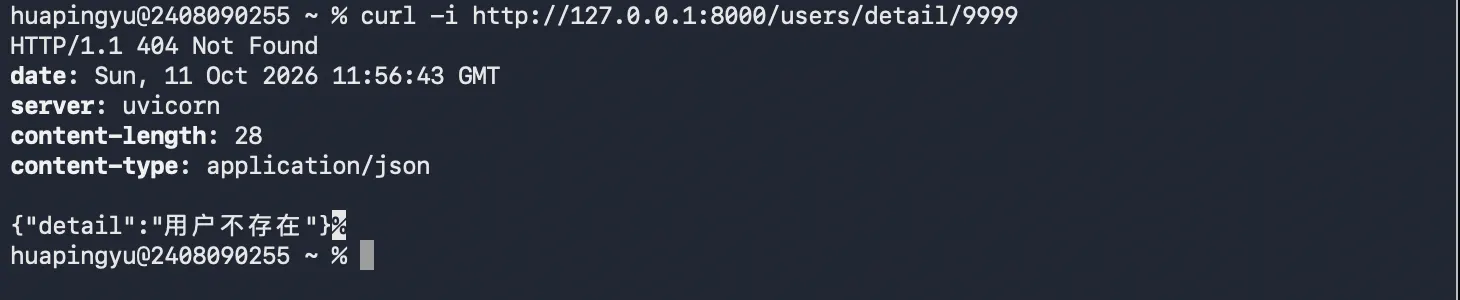
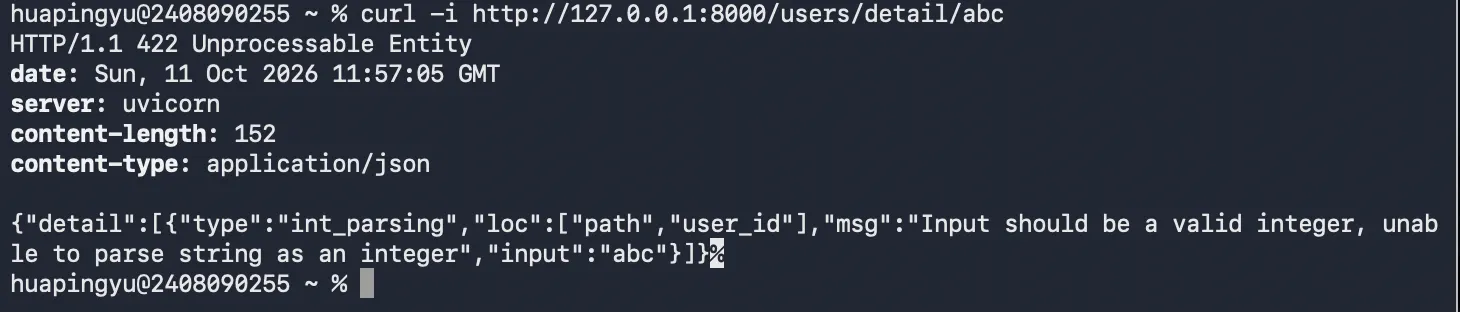
测试 3:参数类型错误
curl -i http://127.0.0.1:8000/users/detail/abc预期返回 422 Unprocessable Entity。
5. 这次的排错思考题
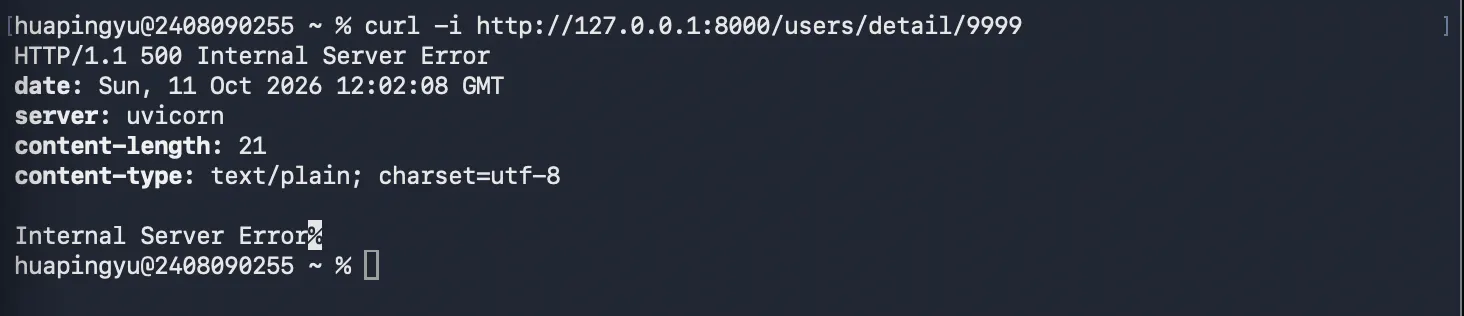
假设现在把代码改成:
@app.get("/users/detail/{user_id}")
def get_user_detail(user_id: int):
    user = users_db.get(user_id)
    return user["name"]
然后访问:
curl -i http://127.0.0.1:8000/users/detail/9999500 不一定是服务器本身出了问题,也可能是业务代码执行时抛出了未处理的异常。
5. FastAPI 项目结构与依赖注入
这一节我们开始从「能写接口」向「能组织一个真实项目」过渡。
之前所有接口都写在 fastapi_demo.py 中。接口少的时候没问题,但如果将来开发 AI Agent 服务,有几十个接口、多个业务模块,全部放在一个文件里就不合适了。
这一节我们学习两个核心知识点:
-
APIRouter:将不同业务的接口拆分到不同文件。
-
Depends:FastAPI 的依赖注入机制。
1. APIRouter 是什么?
你可以把它理解成 Spring Boot 中按业务划分的 Controller。
例如,一个 Agent 后端可能有:
-
用户模块:
/users -
Agent 模块:
/agent -
健康检查:
/health
我们可以把它们拆分到不同的 Python 文件中,而不是全部放进 main.py。
目标项目结构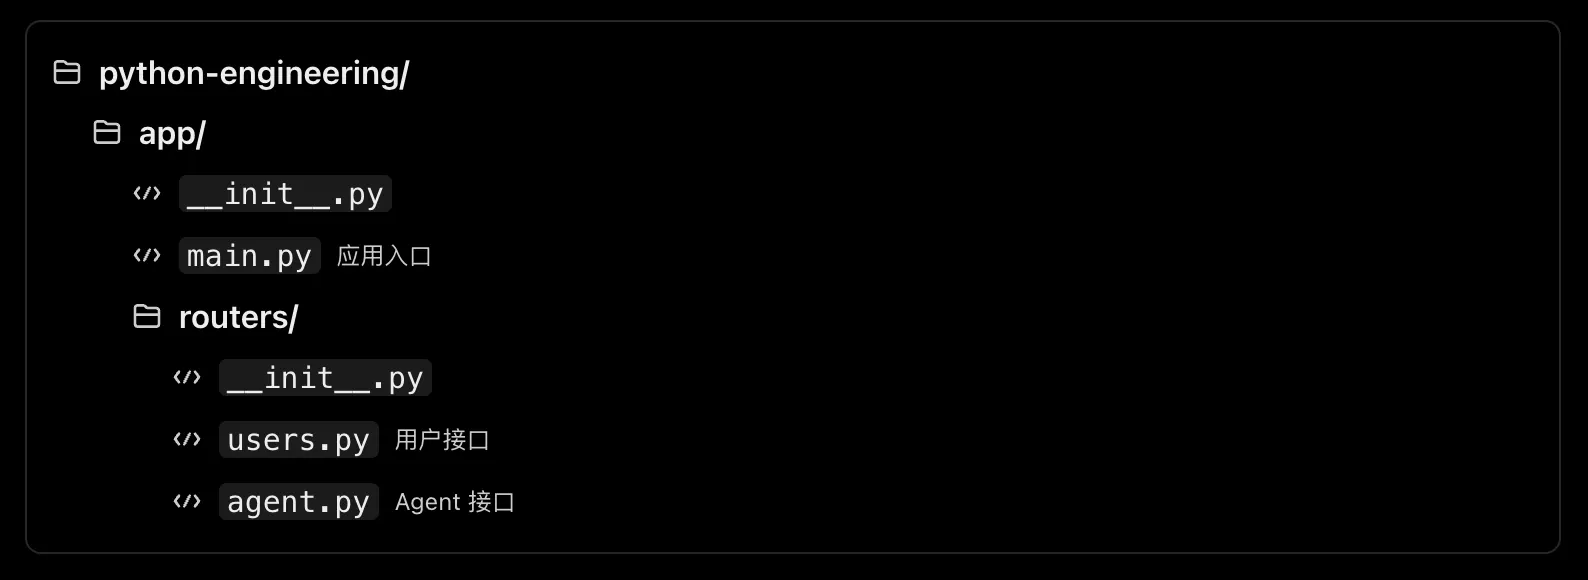
注意:这次我们创建一个新的 app/ 目录,之前的 fastapi_demo.py 保留不动,方便以后回顾。
2. 动手拆分项目
第一步:创建目录
在终端执行:
cd ~/python-engineering

mkdir -p app/routers

touch app/__init__.py
touch app/routers/__init__.py
这里的两个 __init__.py 暂时保持为空即可。
第二步:创建用户接口
nano app/routers/users.py输入:
from fastapi import APIRouter, HTTPException

router = APIRouter(prefix="/users", tags=["Users"])

users_db = {
    1: {"id": 1, "name": "张三"},
    2: {"id": 2, "name": "李四"}
}

@router.get("/{user_id}")
def get_user(user_id: int):
    user = users_db.get(user_id)

    if user is None:
        raise HTTPException(
            status_code=404,
            detail="用户不存在"
        )

    return user
这里有两个新知识点:
① router = APIRouter(prefix="/users")
为这个路由模块设置统一前缀。
因此:
@router.get("/{user_id}")最终对应的完整路径是:
GET /users/{user_id}② tags=["Users"]
用于在 Swagger UI 中给接口分组,不影响接口的实际访问路径。
第三步:创建 Agent 接口
nano app/routers/agent.py输入:
from fastapi import APIRouter
from pydantic import BaseModel, Field

router = APIRouter(prefix="/agent", tags=["Agent"])


class ChatRequest(BaseModel):
    message: str = Field(min_length=1)
    temperature: float = Field(default=0.7, ge=0, le=2)


class ChatResponse(BaseModel):
    reply: str
    model: str


@router.post("/chat", response_model=ChatResponse)
def chat(request: ChatRequest):
    return ChatResponse(
        reply=f"Agent 收到:{request.message}",
        model="demo-agent"
    )
这部分基本都是之前学过的 Pydantic 和 FastAPI 知识,只是把 @app.post() 换成了 @router.post()。
第四步:创建应用入口
nano app/main.py输入:
from fastapi import FastAPI
from app.routers import users, agent

app = FastAPI(title="My Agent API")


@app.get("/health")
def health():
    return {"status": "ok"}


app.include_router(users.router)
app.include_router(agent.router)
重点看:
app.include_router(users.router)
app.include_router(agent.router)
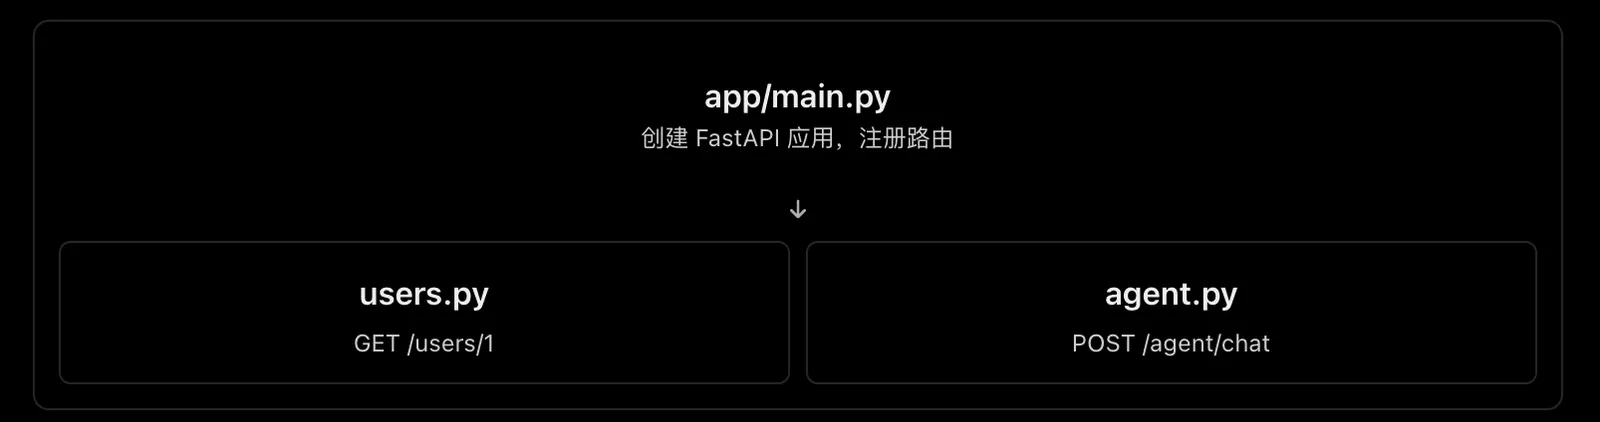
这两行负责把不同文件中定义的路由注册到 FastAPI 应用中。
整个关系可以理解为:
3. 启动新项目
然后在项目根目录执行:
.venv/bin/uvicorn app.main:app --reload注意,这次不再是:
.venv/bin/uvicorn fastapi_demo:app --reload因为应用入口已经变成了 app/main.py。
4. 测试
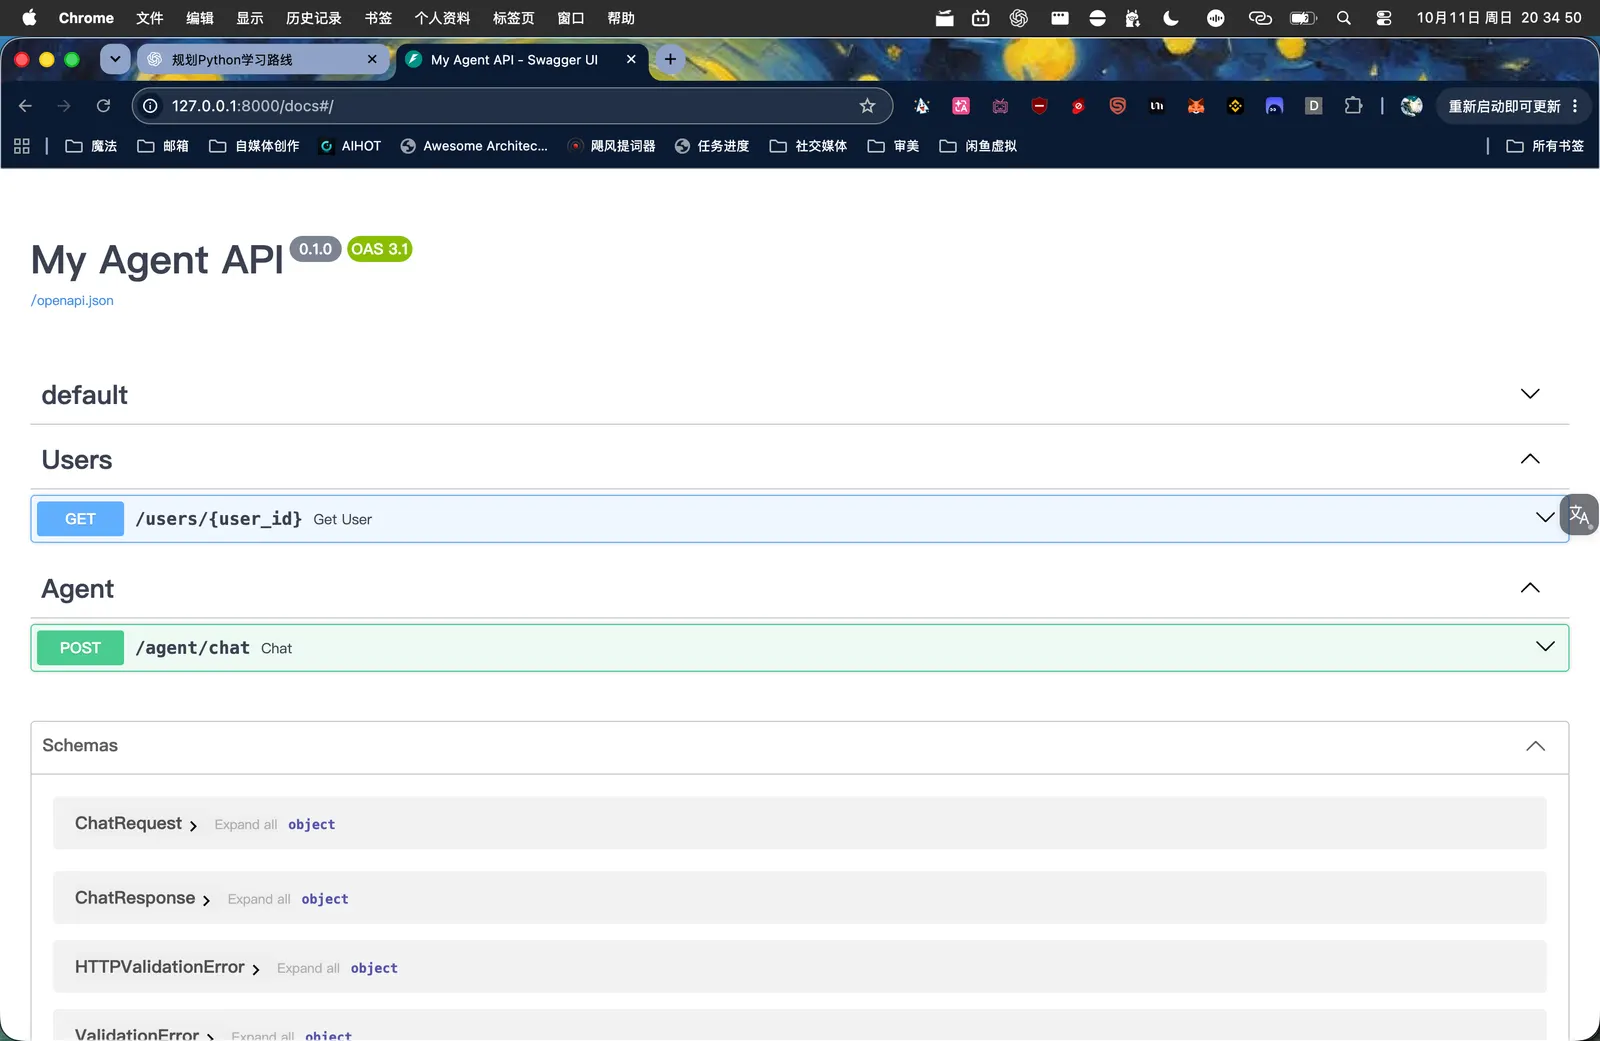
先访问:
你应该能看到按照 Users 和 Agent 分组的接口。
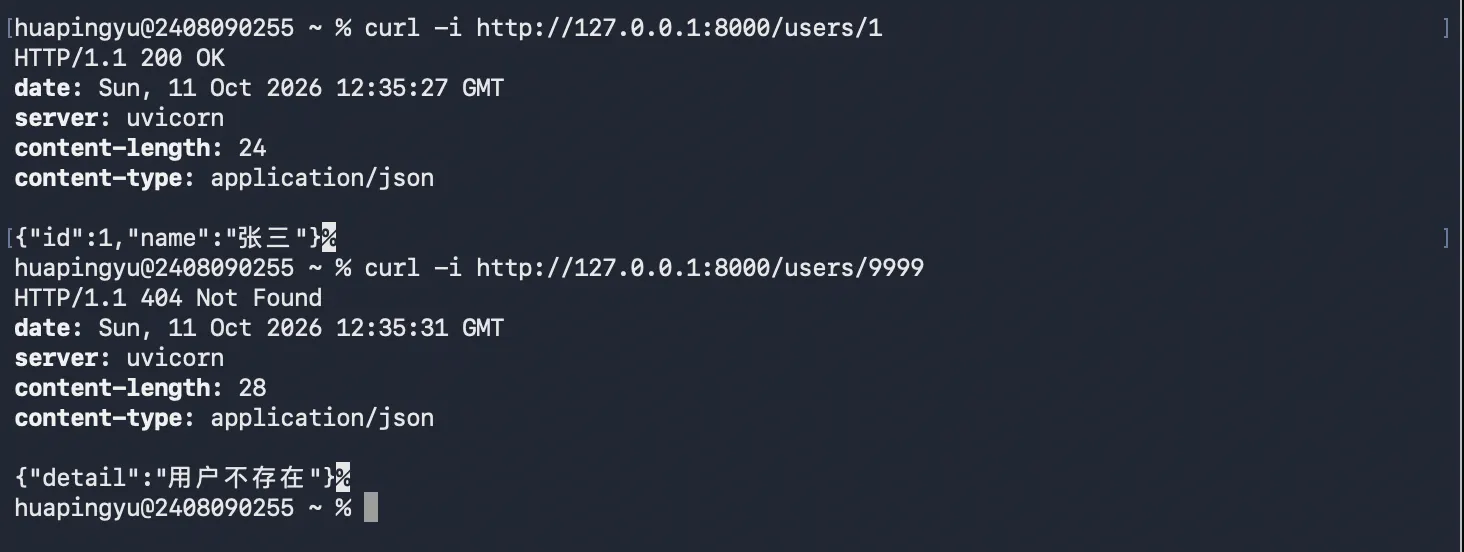
然后在另一个终端执行:
curl -i http://127.0.0.1:8000/users/1预期返回 200 OK 和张三的用户信息。
再执行:
curl -i http://127.0.0.1:8000/users/9999预期返回 404 Not Found。
最后在 Swagger UI 中测试 POST /agent/chat,确认 Agent 接口仍然可以正常工作。
5. 什么是依赖注入?
首先要区分两个概念。
-
依赖(Dependency):一个类或函数完成工作时,需要其他对象、配置或功能的支持。
-
依赖注入(Dependency Injection,DI):使用者不负责创建或获取依赖,而是由外部提供。
我们用之前的 Agent 举例。
1. 不使用依赖注入
class Agent:
    def __init__(self):
        self.llm = OpenAI()

    def chat(self):
        return self.llm.generate()
这里的关键代码是:
self.llm = OpenAI()当创建 Agent 实例时,Agent 内部会创建一个 OpenAI 对象。
如果要改用 DeepSeek,就需要修改 Agent 内部的实现。
2. 使用依赖注入
class Agent:
    def __init__(self, llm):
        self.llm = llm

    def chat(self):
        return self.llm.generate()


agent1 = Agent(OpenAI())
agent2 = Agent(DeepSeek())
这里的关键代码是:
self.llm = llmllm 是外部传入的对象。
Agent 不再负责创建客户端,而是直接使用外部提供的客户端。
只要两个客户端都支持兼容的 generate() 方法,就可以在不修改 Agent 类的情况下切换实现。
核心区别:依赖由内部创建,还是由外部提供。
依赖注入的主要价值是降低耦合,让代码更容易替换、测试和维护。
6. FastAPI 的 Depends() 是什么?
在普通 Python 中,我们可以手动完成依赖注入:
config = get_config()
chat(config)
而在 FastAPI 中,可以使用 Depends() 把依赖的获取和传递交给框架管理。
from fastapi import FastAPI, Depends

app = FastAPI()

def get_config():
    return {"model": "DeepSeek"}

@app.get("/agent/config")
def read_config(config: dict = Depends(get_config)):
    return config
这段代码中:
config: dict = Depends(get_config)相当于告诉 FastAPI:
这个接口需要
get_config()提供的配置。请在处理请求时帮我调用它,并把返回值传给config。
注意,我们仍然需要自己实现 get_config()。
FastAPI 接管的是依赖的调用、解析和传递过程,而不是替我们编写获取配置的业务逻辑。
7. Depends() 什么时候执行?
假设有下面的代码:
def get_config():
    print("① 正在获取配置")
    return {"model": "DeepSeek"}

@app.get("/agent/config")
def read_config(config: dict = Depends(get_config)):
    print("② 正在执行接口")
    return config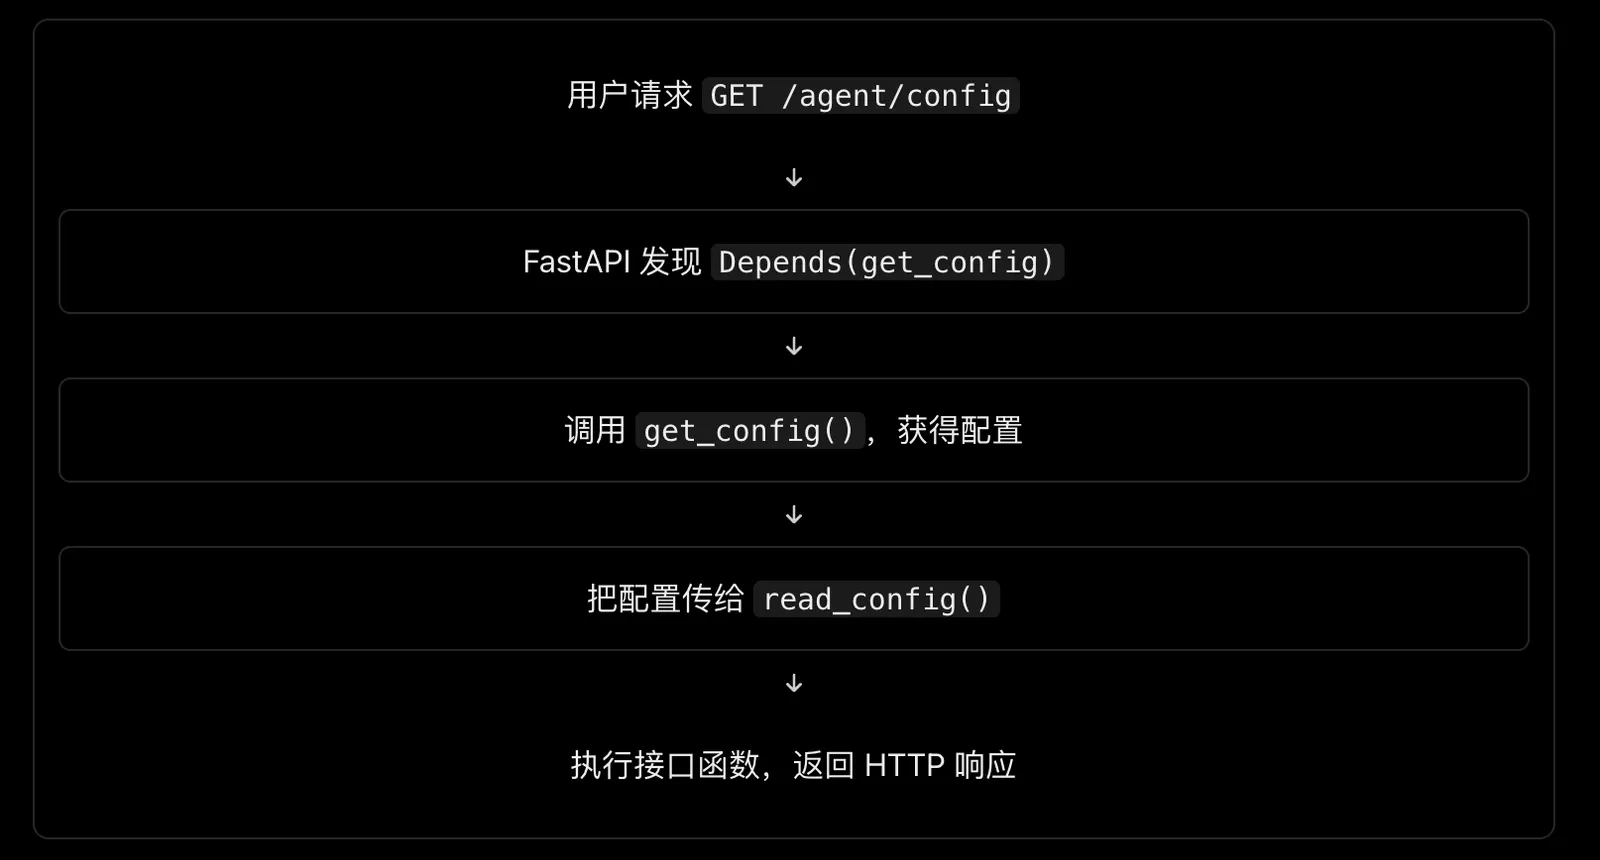
因此:
-
没有请求时,不会因为这个接口的依赖声明而执行
get_config()。 -
有请求时,FastAPI 会在执行接口函数之前准备好依赖。
-
即使接口函数没有使用
config参数,声明的依赖仍然会执行。
这确实有一点懒加载的感觉,但不是等到函数内部第一次读取 config 时才执行。
8. Depends() 会缓存依赖吗?
会,但默认是请求级缓存,不是永久缓存。
假设连续发送两次请求:
GET /agent/config
GET /agent/config
终端会输出:
① 正在获取配置
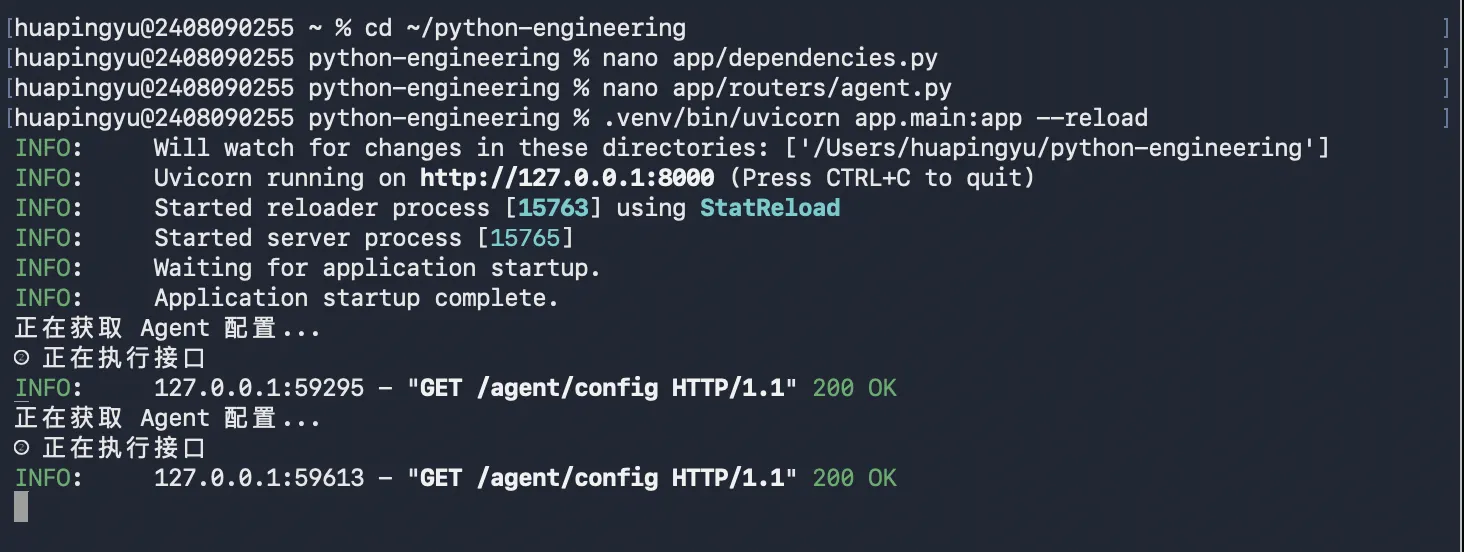
② 正在执行接口

① 正在获取配置
② 正在执行接口
因为每次 HTTP 请求都会重新解析依赖。
不过,如果同一次请求中的多个位置使用了同一个依赖,FastAPI 默认会复用这次请求内的依赖结果,避免重复执行。
如果希望配置跨请求复用,需要另外使用缓存机制,例如 @lru_cache,而不是依赖 Depends() 的默认行为。
9. 依赖注入有什么实际用途?
除了获取配置,依赖注入还经常用于身份验证、数据库连接、获取当前用户等场景。
例如,验证用户的 API Token:
from fastapi import Depends, Header, HTTPException

def check_token(x_token: str = Header()):
    if x_token != "123456":
        raise HTTPException(
            status_code=401,
            detail="Token 无效"
        )

    return x_token

@app.get("/agent/chat")
def chat(token: str = Depends(check_token)):
    return {"message": "验证成功"}
执行过程:
-
用户访问
/agent/chat。 -
FastAPI 从请求头中读取
X-Token,提供给check_token()。 -
check_token()验证 Token。 -
如果验证失败,抛出 401 异常,接口函数不会执行。
-
如果验证成功,FastAPI 将返回值传给
chat(),继续执行接口。
这意味着,我们可以把身份验证逻辑从具体的业务接口中抽离出来,供多个接口复用。
如果只需要执行验证,不需要使用验证函数的返回值,还可以写成:
@app.get(
    "/agent/chat",
    dependencies=[Depends(check_token)]
)
def chat():
    return {"message": "验证成功"}
这种方式同样会在接口执行前进行验证。
10. 一个容易犯的错误
要区分:
Depends(get_config)和:
Depends(get_config())| 写法 | 含义 |
|---|---|
get_config |
函数本身 |
get_config() |
立即调用函数,得到返回值 |
Depends(get_config) |
将函数交给 FastAPI,处理请求时再调用 |
Depends(get_config()) |
提前执行函数,再把返回值交给 Depends,通常是错误用法 |
因此,正常声明依赖时传入函数本身,不加括号。
11. 最终总结
| 问题 | 结论 |
|---|---|
| 什么是依赖? | 完成某项工作所需要的其他对象或功能 |
| 什么是依赖注入? | 使用者不自己创建或获取依赖,而是由外部提供 |
| 为什么使用依赖注入? | 降低耦合,便于替换、测试和复用 |
Depends() 是什么? |
FastAPI 提供的依赖声明和管理机制 |
| 谁实现获取依赖的逻辑? | 开发者自己 |
| 谁负责调用并传递依赖? | FastAPI |
| 什么时候执行依赖? | 请求进入对应接口后、接口函数执行之前 |
| 每次请求都会执行吗? | 默认会;同一请求内可复用依赖结果 |
| 依赖函数抛出异常会怎样? | 当前接口函数不会继续执行 |
一句话记忆:依赖注入是把依赖交给外部提供,而 FastAPI 的 Depends() 则让框架在处理请求时自动获取、解析并传递这些依赖。
12. 练习:实际使用 Depends()
这次只做一件事:让 FastAPI 自动获取 Agent 配置,并观察依赖函数的执行过程。
第一步:创建依赖函数
先进入项目:
cd ~/python-engineering创建或打开文件:
nano app/dependencies.py写入:
def get_agent_config():
    print("① 正在获取 Agent 配置")

    return {
        "model": "demo-agent",
        "max_tokens": 1000
    }
这个函数负责提供 Agent 的配置。
第二步:在 Agent 路由中使用 Depends()
打开:
nano app/routers/agent.py保留你之前的代码,只需要增加下面两处内容。
首先,确保有这两个导入:
from fastapi import APIRouter, Depends
from app.dependencies import get_agent_config
然后在文件末尾添加:
@router.get("/config")
def read_config(config: dict = Depends(get_agent_config)):
    print("② 正在执行接口")

    return config
这里我们没有手动调用 get_agent_config(),而是把它交给 FastAPI。
第三步:启动并测试
在项目根目录运行:
.venv/bin/uvicorn app.main:app --reload然后新开一个终端,执行:
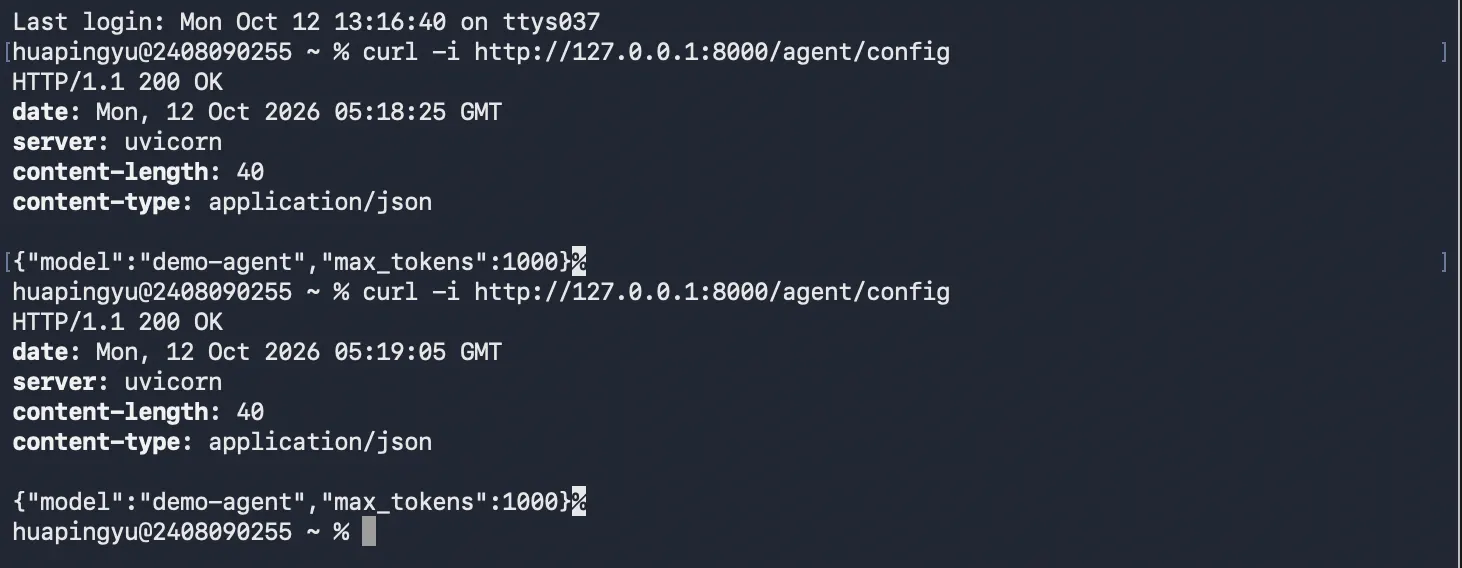
curl -i http://127.0.0.1:8000/agent/config预期 HTTP 响应:
HTTP/1.1 200 OK

{"model":"demo-agent","max_tokens":1000}
原来运行 Uvicorn 的终端则应该出现:
① 正在获取 Agent 配置
② 正在执行接口
这就验证了我们之前讨论的执行顺序:先解析依赖,再执行接口函数。
第四步:再请求一次
不需要重启服务,再执行一次:
curl -i http://127.0.0.1:8000/agent/config观察 Uvicorn 终端。
6. FastAPI 异步接口:结合 httpx.AsyncClient
之前我们已经学习过 asyncio 和 httpx.AsyncClient,所以这次不重新讲异步原理,而是重点学习:
如何让 FastAPI 接口异步调用外部 HTTP 服务。
1. 先理解整体流程
之前我们学习的是 FastAPI 接收请求:
用户 → FastAPI → 返回响应现在增加一个外部服务:
用户 → FastAPI → 外部 HTTP API
                 ↓
用户 ← FastAPI ← 外部 API 的响应
例如以后开发 AI Gateway 时:
客户端 → 我们的 FastAPI → 大模型 API
客户端 ← 我们的 FastAPI ← 大模型响应
我们先使用公开的测试 API 来模拟这个过程,不需要真正调用大模型。
2. 练习:创建异步接口
打开现有文件:
cd ~/python-engineering
nano app/routers/agent.py
在顶部补充:
import httpx
from fastapi import HTTPException
注意保留原来的 APIRouter、Depends 等导入,以及之前写好的接口。
然后在文件末尾添加:
@router.get("/external")
async def get_external_data():
    url = "https://httpbin.org/get"

    async with httpx.AsyncClient(timeout=10.0) as client:
        response = await client.get(url)

    return {
        "status_code": response.status_code,
        "data": response.json()
    }
这里有三个重点:
| 代码 | 作用 |
|---|---|
async def |
定义异步接口函数 |
httpx.AsyncClient() |
创建异步 HTTP 客户端 |
await client.get(url) |
异步等待外部 HTTP 请求完成 |
async with 会在使用结束后自动关闭客户端。
这与之前学习的异步 HTTP 请求基本相同,只不过现在放进了 FastAPI 接口中。
3. 启动并测试
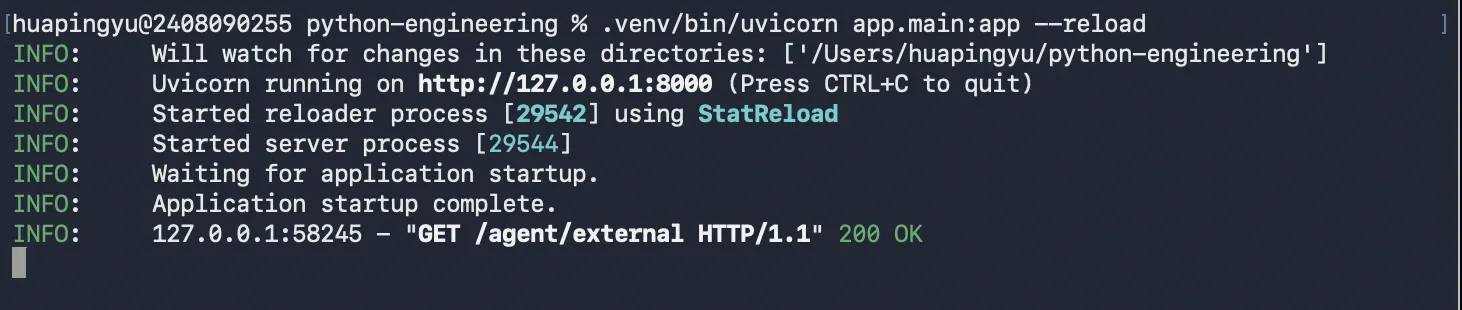
如果 Uvicorn 还在运行,而且使用了 --reload,保存文件后会自动重载。
新开终端执行:
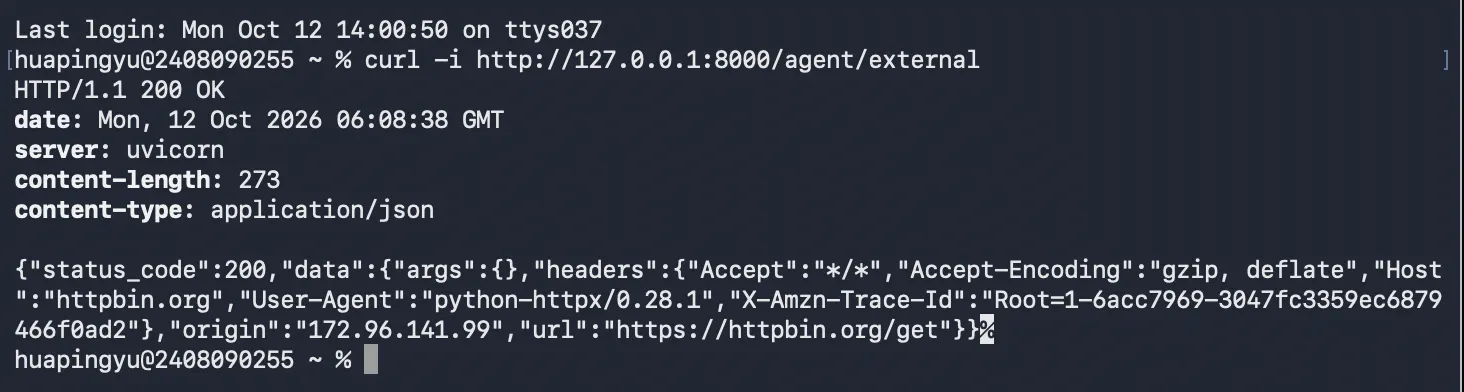
curl -i http://127.0.0.1:8000/agent/external如果外部请求成功,你应该能看到类似的结果:
{
  "status_code": 200,
  "data": {
    "args": {},
    "headers": {},
    "origin": "...",
    "url": "https://httpbin.org/get"
  }
}
实际的 headers、origin 等字段可能不同。
4. 异步 HTTP 请求的异常处理
1. 目前的代码有什么问题?
现在的接口是:
@router.get("/external")
async def get_external_data():
    url = "https://httpbin.org/get"

    async with httpx.AsyncClient(timeout=10.0) as client:
        response = await client.get(url)

    return {
        "status_code": response.status_code,
        "data": response.json()
    }
正常情况下没有问题。
但如果外部服务出现以下情况呢?
-
请求超时。
-
网络连接失败。
-
外部 API 返回 404、500 等错误状态码。
目前没有针对这些情况做处理。
特别注意,httpx 默认不会因为收到 404 或 500 就抛出异常。必须调用 response.raise_for_status() 才会把这些状态码转换成 HTTPStatusError。
2. 增加异常处理
打开文件:
cd ~/python-engineering
nano app/routers/agent.py
找到之前的 get_external_data(),将整个函数替换为:
@router.get("/external")
async def get_external_data():
    url = "https://httpbin.org/get"

    try:
        async with httpx.AsyncClient(timeout=10.0) as client:
            response = await client.get(url)
            response.raise_for_status()

        return {
            "status_code": response.status_code,
            "data": response.json()
        }

    except httpx.TimeoutException:
        raise HTTPException(
            status_code=504,
            detail="外部 API 请求超时"
        )

    except httpx.HTTPStatusError as e:
        raise HTTPException(
            status_code=502,
            detail=f"外部 API 返回错误状态码:{e.response.status_code}"
        )

    except httpx.RequestError:
        raise HTTPException(
            status_code=502,
            detail="外部 API 网络请求失败"
        )
这里没有引入太多新知识,主要就是把之前学过的 try/except、httpx 异常和 FastAPI 的 HTTPException 组合起来。
3. 三种异常分别处理什么?
| 异常 | 触发场景 | 我们返回 |
|---|---|---|
TimeoutException |
外部请求超时 | 504 |
HTTPStatusError |
外部返回 4xx / 5xx,且调用了 raise_for_status() |
502 |
RequestError |
DNS、连接失败等请求问题 | 502 |
其中 502 和 504 是我们作为 API 服务对外返回的状态码,不一定与外部服务原本的状态码相同。
这里的异常处理是教学版。实际项目还需要日志记录、错误信息保护等。
4. 实际验证异常处理
这次我们不只是测试正常请求,还要主动制造一个错误。
测试 1:正常请求
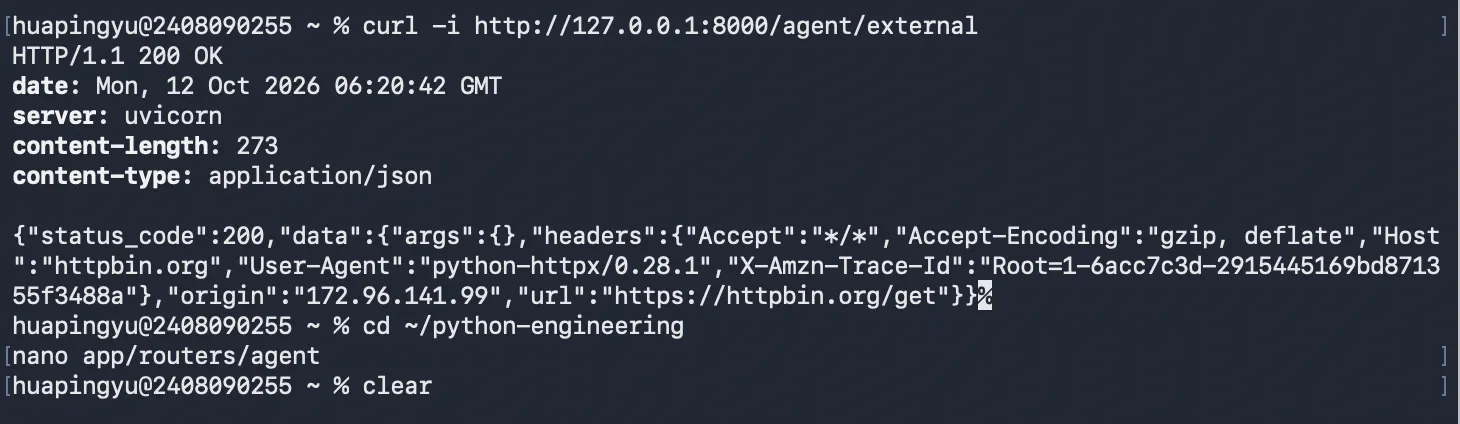
保持:
url = "https://httpbin.org/get"执行:
curl -i http://127.0.0.1:8000/agent/external预期仍然是 200 OK。
测试 2:模拟外部 API 返回 500
将 URL 暂时修改成:
url = "https://httpbin.org/status/500"再次执行:
curl -i http://127.0.0.1:8000/agent/external如果 httpbin 正常返回预设状态码,预期结果是:
HTTP/1.1 502 Bad Gateway{
"detail": "外部 API 返回错误状态码:500"
}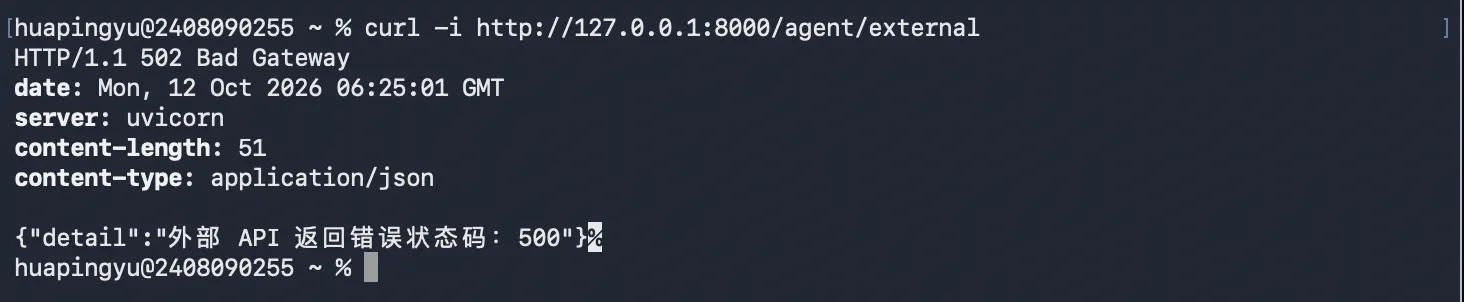
为什么外部 API 返回 500,而我们的 FastAPI 返回 502?
因为我们的服务本身没有发生未处理的内部异常,而是调用上游服务时,上游返回了错误响应。
在这种 API 代理场景下,用 502 表达上游响应异常是合理的。
5. FastAPI 综合实战:开发一个小型 Agent API
目标:实现一个能够接收聊天消息、读取 Agent 配置、异步请求外部服务,并返回统一响应的 API。
这里先不接入真正的大模型,使用 httpbin.org 模拟外部 API。这样可以把注意力放在 Python 工程能力上。
1. 先理解整体流程
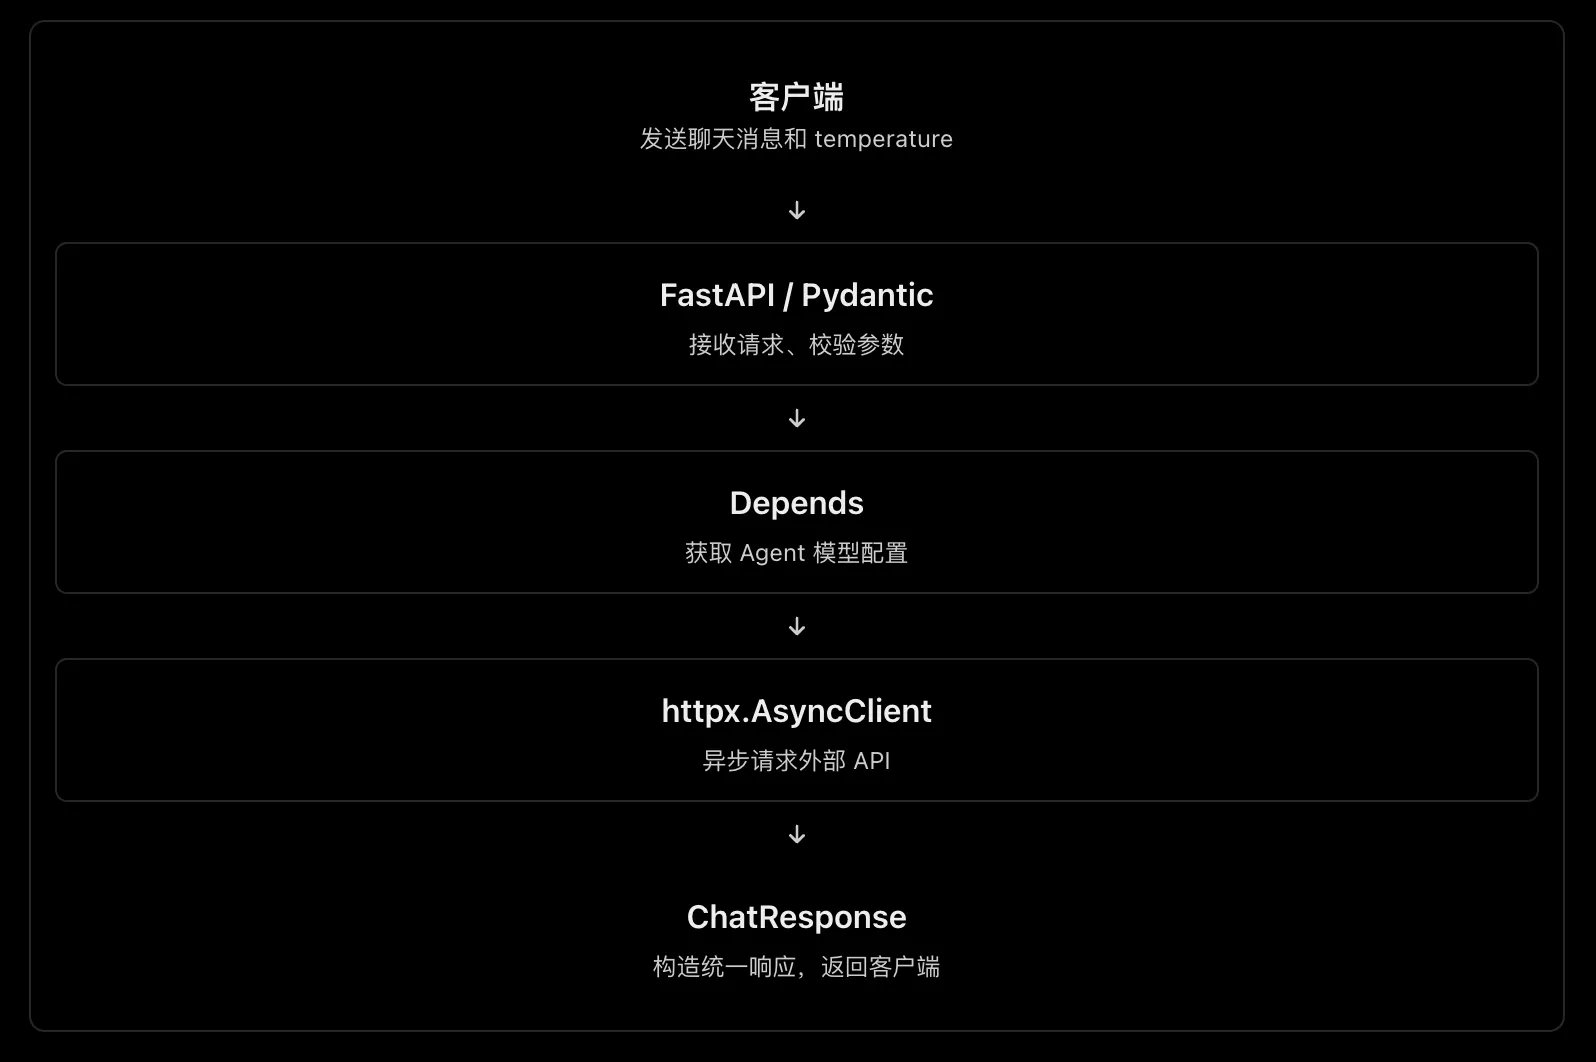
2. 编写完整代码
这次我们直接提供完整文件代码,避免之前误删部分代码的问题。
第一步:确认配置文件
打开:
cd ~/python-engineering
nano app/dependencies.py
确保文件内容为:
def get_agent_config():
    return {
        "model": "demo-agent",
        "max_tokens": 1000
    }
第二步:替换 Agent 路由文件
打开:
nano app/routers/agent.py清空:
truncate -s 0 app/routers/agent.py下面是整个文件的完整代码,可以直接覆盖原有内容。 我们会保留之前的聊天、配置和外部请求接口,同时新增 /agent/chat/complete。
import httpx

from fastapi import APIRouter, Depends, HTTPException
from pydantic import BaseModel, Field

from app.dependencies import get_agent_config


# ==================== 1. 路由 ====================

router = APIRouter(prefix="/agent", tags=["Agent"])


# ==================== 2. 数据模型 ====================

class ChatRequest(BaseModel):
    message: str = Field(min_length=1)
    temperature: float = Field(default=0.7, ge=0, le=2)


class ChatResponse(BaseModel):
    reply: str
    model: str

# ==================== 3. 基础聊天接口 ====================

@router.post("/chat", response_model=ChatResponse)
def chat(request: ChatRequest):
    return ChatResponse(
        reply=f"Agent 收到:{request.message}",
        model="demo-agent"
    )


# ==================== 4. 配置接口 ====================

@router.get("/config")
def read_config(config: dict = Depends(get_agent_config)):
    return config


# ==================== 5. 外部 HTTP 接口 ====================

@router.get("/external")
async def get_external_data():
    url = "https://httpbin.org/get"

    try:
        async with httpx.AsyncClient(timeout=10.0) as client:
            response = await client.get(url)
            response.raise_for_status()

        return {
            "status_code": response.status_code,
            "data": response.json()
        }

    except httpx.TimeoutException:
        raise HTTPException(
            status_code=504,
            detail="外部 API 请求超时"
        )

    except httpx.HTTPStatusError as e:
        raise HTTPException(
            status_code=502,
            detail=f"外部 API 返回错误状态码:{e.response.status_code}"
        )

    except httpx.RequestError:
        raise HTTPException(
            status_code=502,
            detail="外部 API 网络请求失败"
        )


# ==================== 6. 综合 Agent API ====================

@router.post("/chat/complete", response_model=ChatResponse)
async def complete_chat(
    request: ChatRequest,
    config: dict = Depends(get_agent_config)
):
    url = "https://httpbin.org/post"

    payload = {
        "message": request.message,
        "temperature": request.temperature,
        "model": config["model"]
    }

    try:
        async with httpx.AsyncClient(timeout=10.0) as client:
            response = await client.post(url, json=payload)
            response.raise_for_status()

        data = response.json()
        received = data["json"]

        return ChatResponse(
            reply=f"模拟 Agent 收到:{received['message']}",
            model=received["model"]
        )

    except httpx.TimeoutException:
        raise HTTPException(
            status_code=504,
            detail="外部服务请求超时"
        )

    except httpx.HTTPStatusError as e:
        raise HTTPException(
            status_code=502,
            detail=f"外部服务返回错误:{e.response.status_code}"
        )

    except httpx.RequestError:
        raise HTTPException(
            status_code=502,
            detail="外部服务网络请求失败"
        )

    except (ValueError, KeyError, TypeError):
        raise HTTPException(
            status_code=502,
            detail="外部服务返回的数据格式不正确"
        )
3. 这里真正整合了哪些知识?
重点看新增的 complete_chat()。
第一部分:Pydantic + Depends
async def complete_chat(
    request: ChatRequest,
    config: dict = Depends(get_agent_config)
):
FastAPI 会先通过 Pydantic 校验用户提交的请求,同时调用 get_agent_config() 获取配置。
第二部分:构造请求数据
payload = {
    "message": request.message,
    "temperature": request.temperature,
    "model": config["model"]
}
这里把用户提供的参数和服务端的模型配置组合起来。
第三部分:异步调用外部服务
async with httpx.AsyncClient(timeout=10.0) as client:
    response = await client.post(url, json=payload)
    response.raise_for_status()
httpbin.org/post 会把我们发送的 JSON 数据回显回来,方便检查。
第四部分:解析响应
data = response.json()received = data["json"]因为 httpbin 返回的数据大致是:
{
  "json": {
    "message": "你好",
    "temperature": 0.7,
    "model": "demo-agent"
  }
}
所以我们通过 data["json"] 取得之前发送的数据。
注意:这只是模拟外部 API 调用,并没有真正生成 AI 回复。
4. 运行测试
1. 检查语法
.venv/bin/python -m py_compile app/routers/agent.py没有输出代表语法检查通过。
2. 启动 FastAPI
.venv/bin/uvicorn app.main:app --reload如果之前的 Uvicorn 还在运行,保存文件后等待它自动重载即可。
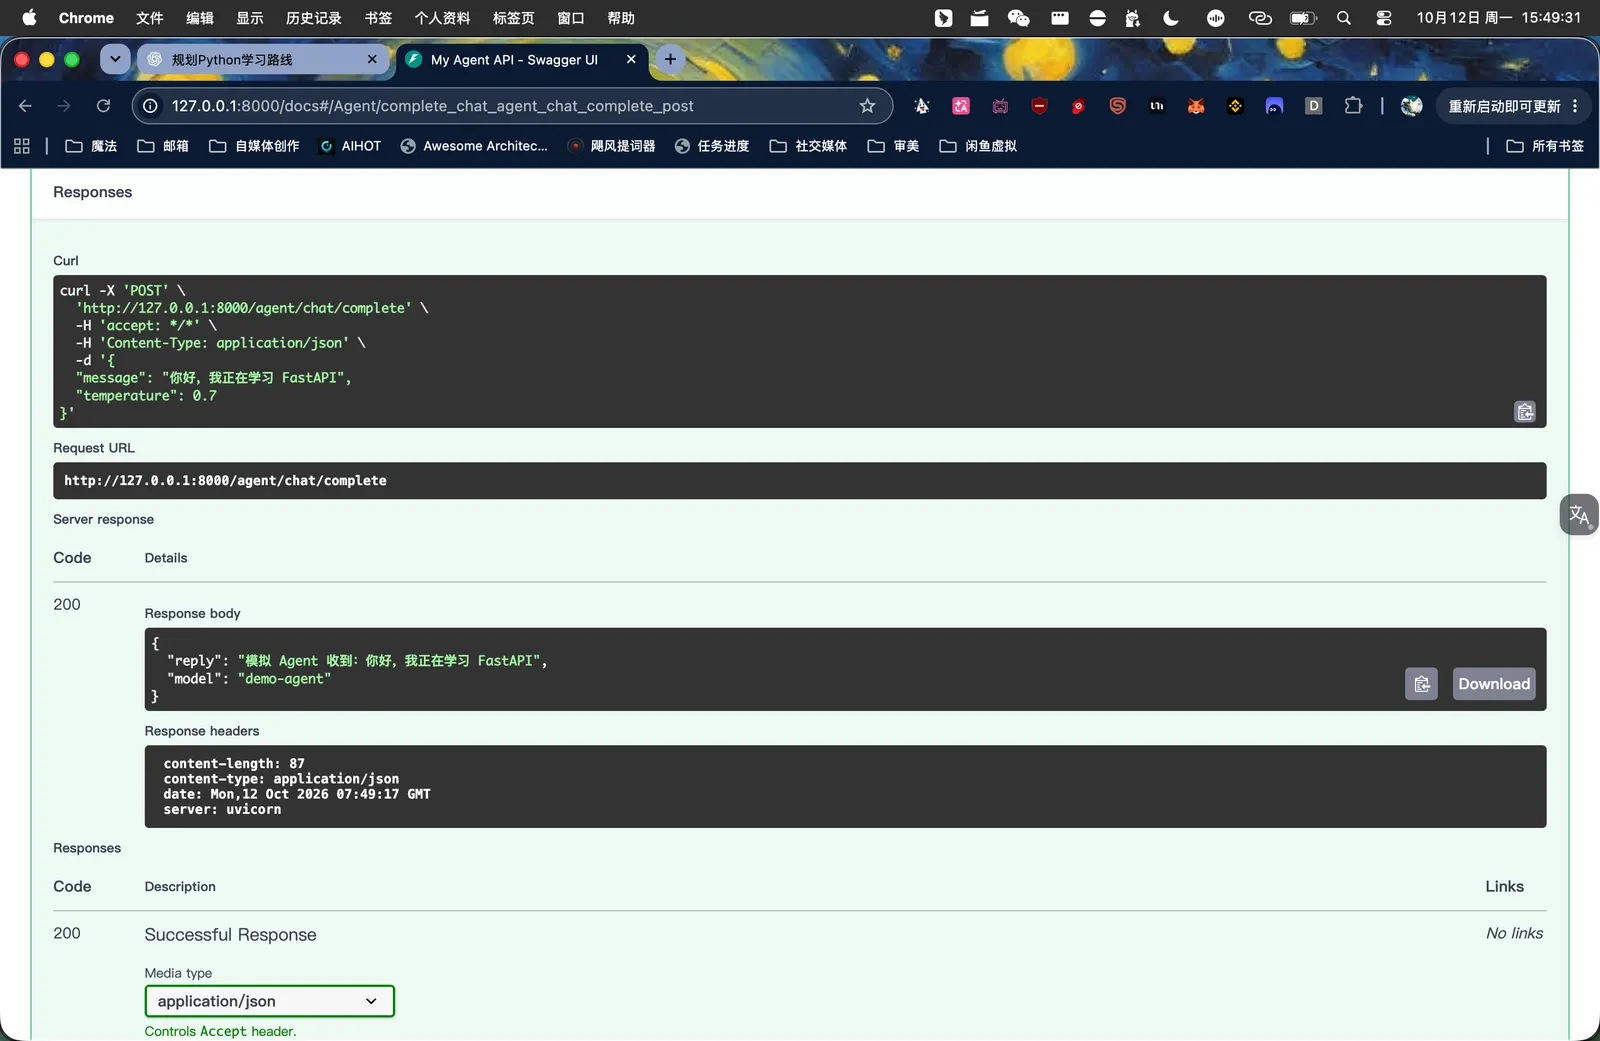
**3. 使用 Swagger 测试
打开:
找到:
POST /agent/chat/complete
点击 Try it out,输入:
{
  "message": "你好,我正在学习 FastAPI",
  "temperature": 0.7
}
点击 Execute。
预期返回:
{
  "reply": "模拟 Agent 收到:你好,我正在学习 FastAPI",
  "model": "demo-agent"
}
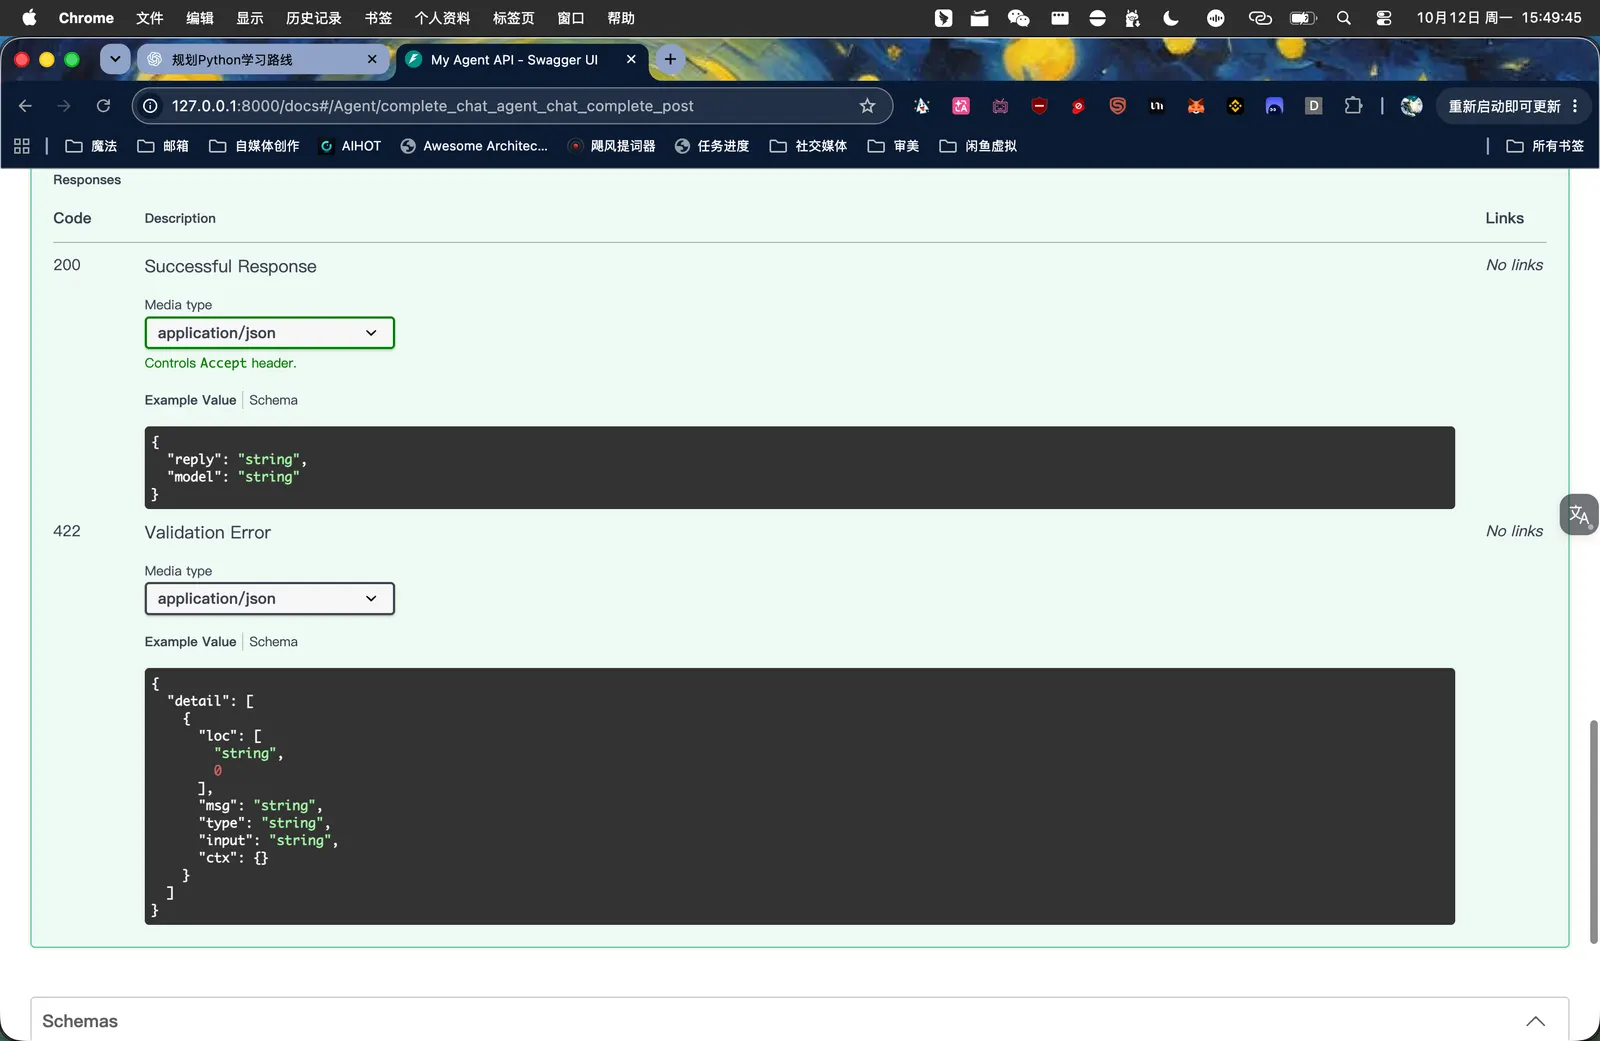
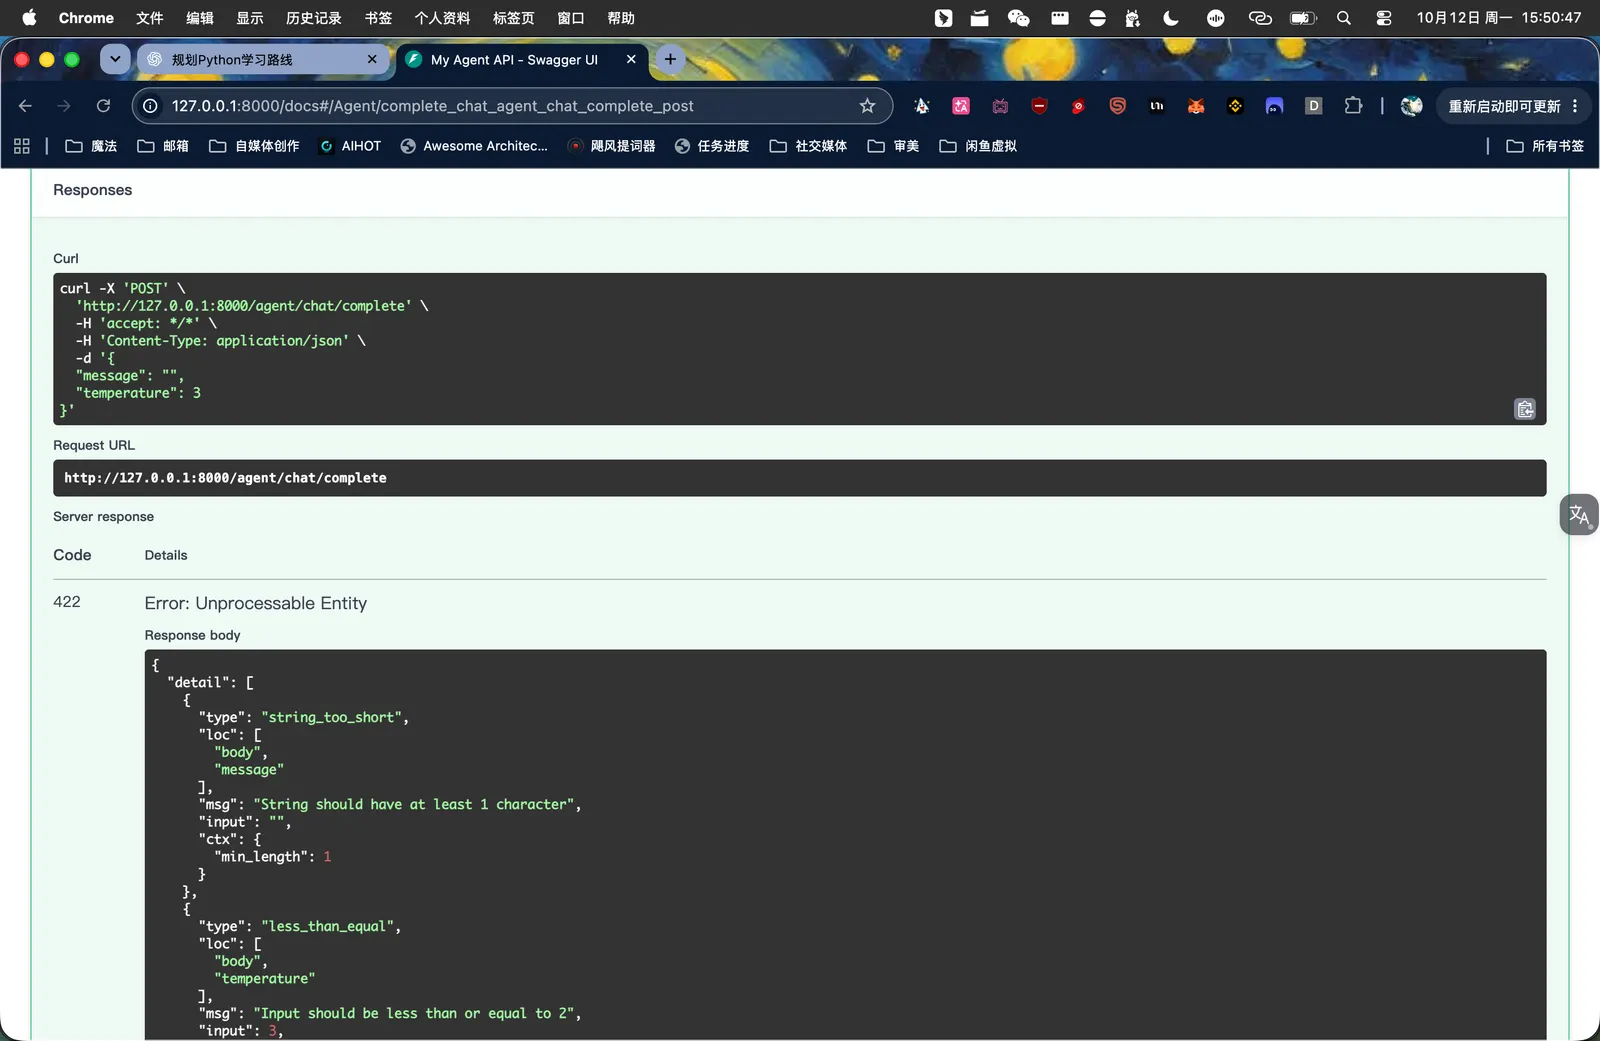
5. 再做一个异常测试
把请求改成:
{
  "message": "",
  "temperature": 3
}
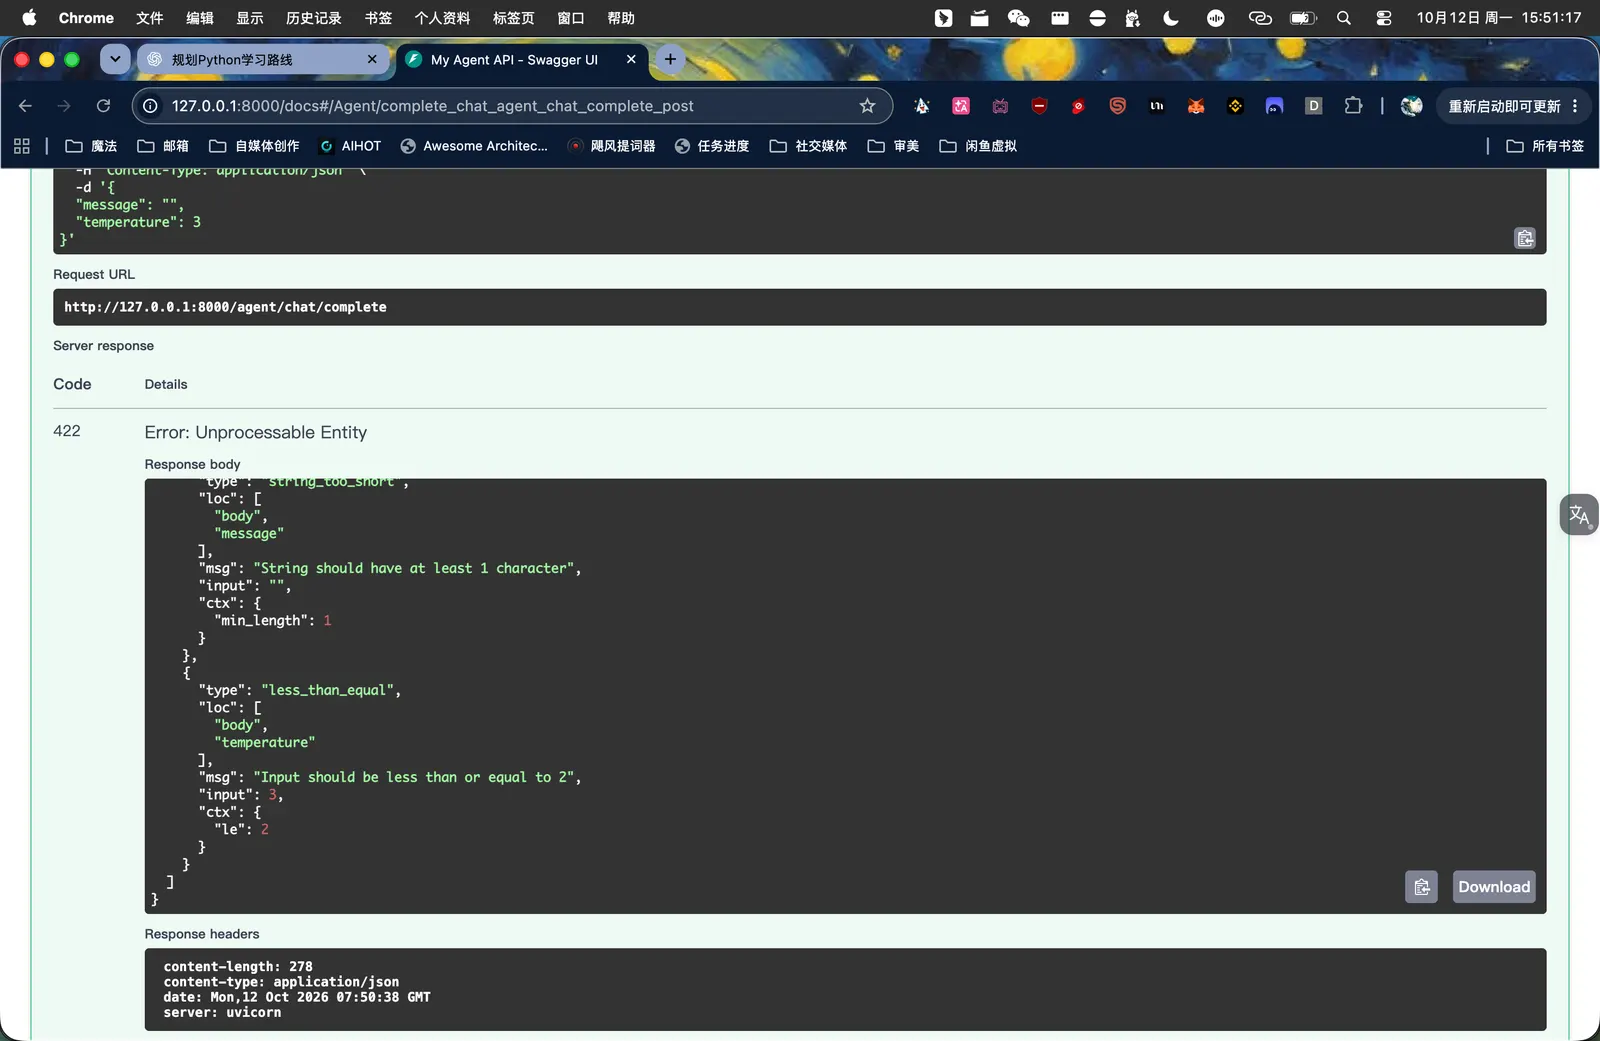
预期 FastAPI 返回 422 Unprocessable Entity。
原因是:
-
message不能是空字符串。 -
temperature最大只能为 2。
这次验证的是 Pydantic 在调用外部 API 之前就拦截了不合法的请求。
7. Router、Schema、Service 分层
1. 为什么需要分层?
先回顾一下我们现在的接口:
@router.post("/chat/complete", response_model=ChatResponse)
async def complete_chat(
    request: ChatRequest,
    config: dict = Depends(get_agent_config)
):
    # 构造请求数据
    # 调用外部 API
    # 处理异常
    # 解析响应
    # 返回结果
它虽然能够正常运行,但有一个问题:
Router 承担了太多职责。
既要处理 HTTP 请求,又要调用外部服务,还要解析响应和处理业务逻辑。
如果以后增加多个模型提供商、重试机制、对话历史管理,这个文件会越来越复杂。
所以我们需要分层。
2. 三个层次分别负责什么?
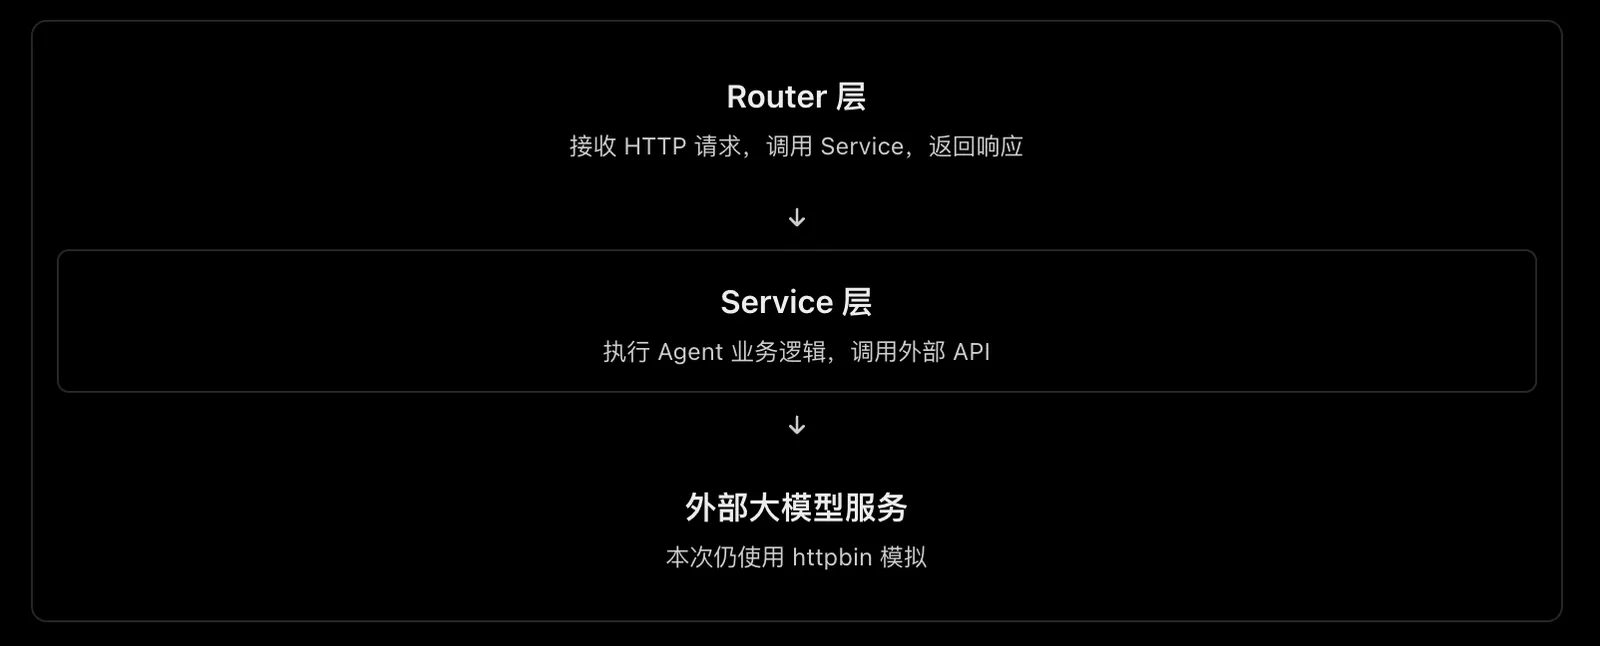
另外还有 Schema 层,用于定义 Router 和 Service 使用的数据结构。
如果联系你之前学过的 Java 后端,可以大致理解为:
| Python / FastAPI | Java / Spring Boot |
|---|---|
| Router | Controller |
| Service | Service |
| Schema(Pydantic) | DTO / VO |
这只是职责上的类比,并不代表两个框架的机制完全相同。
3. 抽离 Schema
这次我们不一次性修改整个项目,而是先做最简单的一步:把 Pydantic 模型从 Router 中抽离出来。
1. 创建目录和文件
进入项目:
cd ~/python-engineering
mkdir -p app/schemas
touch app/schemas/__init__.py
nano app/schemas/chat.py
把下面的完整代码粘贴进去:
from pydantic import BaseModel, Field

class ChatRequest(BaseModel):
    message: str = Field(min_length=1)
    temperature: float = Field(default=0.7, ge=0, le=2)

class ChatResponse(BaseModel):
    reply: str
    model: str
这里没有新语法,只是把之前写在 agent.py 中的两个类搬到了 schemas/chat.py。
2. 修改 Router 的 import
打开:
nano app/routers/agent.py找到文件顶部的:
from pydantic import BaseModel, Field删除这一行,替换成:
from app.schemas.chat import ChatRequest, ChatResponse接着找到原本的:
class ChatRequest(BaseModel):
    message: str = Field(min_length=1)
    temperature: float = Field(default=0.7, ge=0, le=2)

class ChatResponse(BaseModel):
    reply: str
    model: str
把这两个类的定义从 agent.py 中删除。
注意:这次只修改这两个位置,其他接口代码全部保留,不要清空整个文件。
3. 验证是否成功
保存后,在项目根目录执行:
.venv/bin/python -m py_compile app/schemas/chat.py app/routers/agent.py接着检查模块能否正常导入:
.venv/bin/python -c "from app.main import app; print('Import OK')"预期输出:
Import OK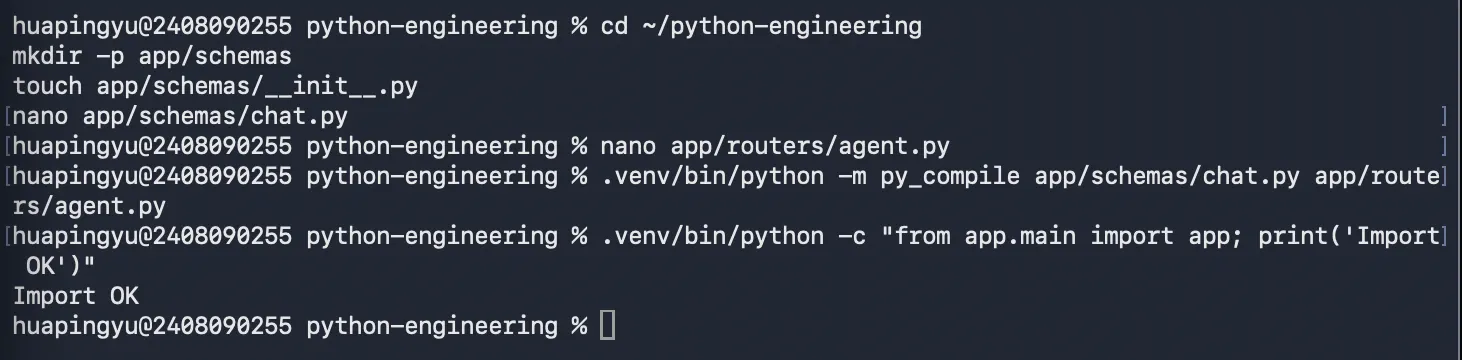
如果 Uvicorn 仍然运行,使用 Swagger 或下面的命令确认接口正常:
curl -i http://127.0.0.1:8000/agent/config预期返回 200 OK。
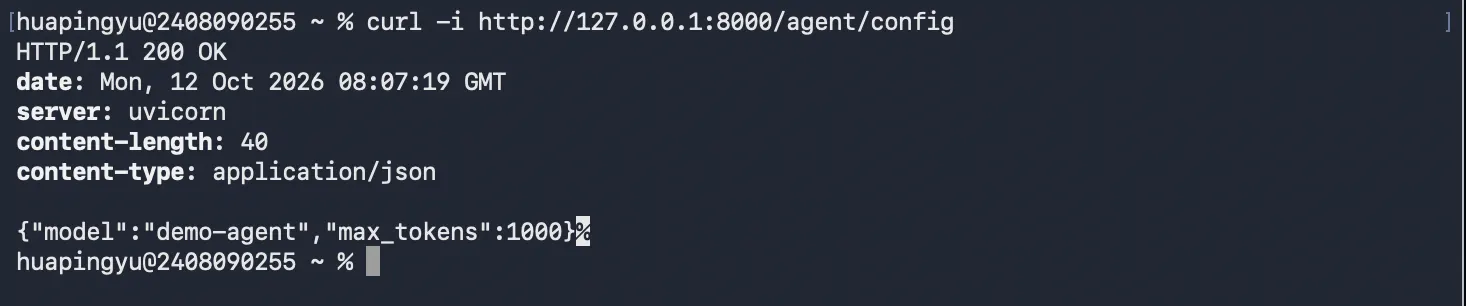
4. 这一步真正改变了什么?
修改之前:
app/
└── routers/
    └── agent.py
        ├── ChatRequest
        ├── ChatResponse
        └── 各种接口函数
修改之后:
app/
├── routers/
│   └── agent.py
│       └── 各种接口函数
└── schemas/
    ├── __init__.py
    └── chat.py
        ├── ChatRequest
        └── ChatResponse
接口行为完全没有改变,只是代码的组织方式发生了变化。
这类修改叫作重构(Refactoring):在尽量不改变外部行为的前提下,改善代码的内部结构。
4. Service 层拆分
1. 为什么还要拆 Service 层?
现在 agent.py 中的 /chat/complete 接口同时负责接收请求、调用外部 API、解析结果和处理异常。
我们希望将职责拆开:
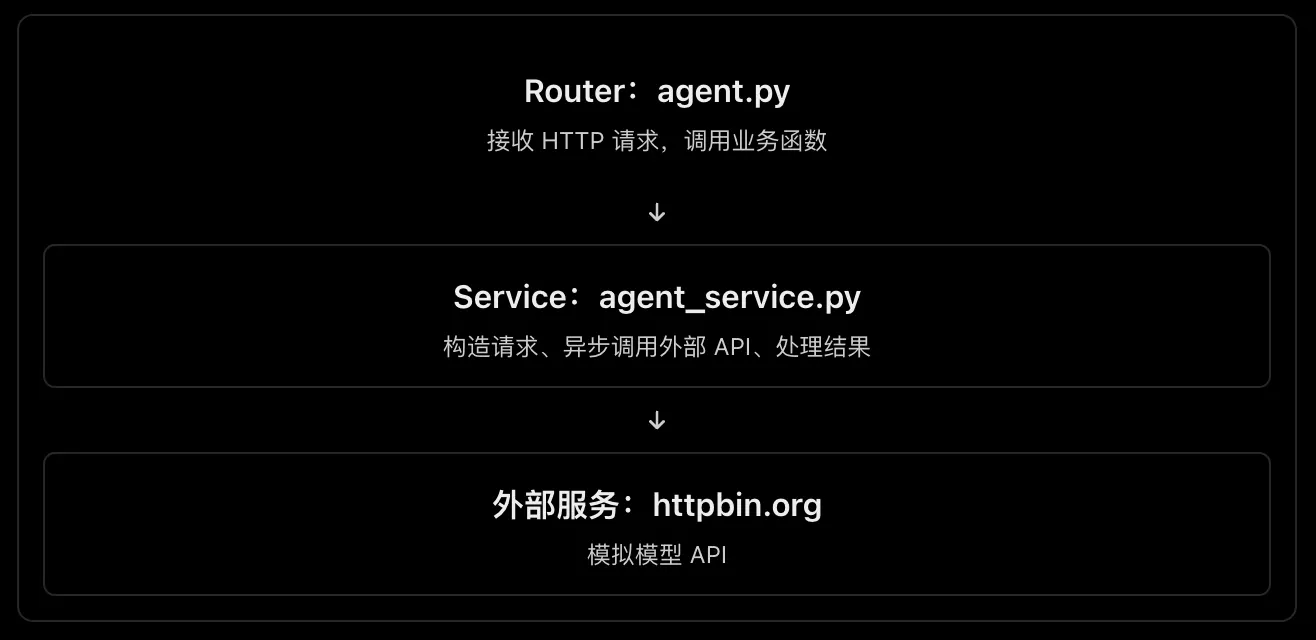
这与 Java 后端中的 Controller 调用 Service 非常相似。
2. 创建 Service 文件
进入项目:
cd ~/python-engineering
mkdir -p app/services
touch app/services/__init__.py
nano app/services/agent_service.py
下面是新文件 app/services/agent_service.py 的完整代码,可以直接粘贴。
import httpx

from fastapi import HTTPException

from app.schemas.chat import ChatRequest, ChatResponse

async def generate_reply(
    request: ChatRequest,
    config: dict
) -> ChatResponse:

    url = "https://httpbin.org/post"

    payload = {
        "message": request.message,
        "temperature": request.temperature,
        "model": config["model"]
    }

    try:
        async with httpx.AsyncClient(timeout=10.0) as client:
            response = await client.post(url, json=payload)
            response.raise_for_status()

        data = response.json()
        received = data["json"]

        return ChatResponse(
            reply=f"模拟 Agent 收到:{received['message']}",
            model=received["model"]
        )

    except httpx.TimeoutException:
        raise HTTPException(
            status_code=504,
            detail="外部服务请求超时"
        )

    except httpx.HTTPStatusError as e:
        raise HTTPException(
            status_code=502,
            detail=f"外部服务返回错误:{e.response.status_code}"
        )

    except httpx.RequestError:
        raise HTTPException(
            status_code=502,
            detail="外部服务网络请求失败"
        )

    except (ValueError, KeyError, TypeError):
        raise HTTPException(
            status_code=502,
            detail="外部服务返回的数据格式不正确"
        )
这段代码没有新增知识点,只是把原本写在 Router 里的业务逻辑搬到了 Service。
3. 修改 Router,让它调用 Service
打开:
nano app/routers/agent.py这次不需要清空整个文件,只修改两个位置。
修改 1:添加 import
在文件顶部添加:
from app.services.agent_service import generate_reply保留其他 import。
修改 2:替换 complete_chat 函数
找到:
@router.post("/chat/complete", response_model=ChatResponse)将这个装饰器及其下方整个 complete_chat() 函数替换为:
@router.post("/chat/complete", response_model=ChatResponse)
async def complete_chat(
    request: ChatRequest,
    config: dict = Depends(get_agent_config)
):
    return await generate_reply(request, config)
注意:只替换 /chat/complete,不要删除 /chat、/config 和 /external 接口。
现在 Router 的代码明显简单了。
它不再关心外部 API 的 URL、请求数据如何构造,以及响应如何解析。
只负责:
-
接收并校验请求。
-
通过 Depends 获取配置。
-
调用 Service,返回结果。
这里的:
return await generate_reply(request, config)意思是异步等待 Service 完成工作,然后将结果返回给客户端。
4. 验证重构结果
先检查语法和导入:
.venv/bin/python -m py_compile app/services/agent_service.py app/routers/agent.py.venv/bin/python -c "from app.main import app; print('Import OK')"接着在 Swagger 中重新测试:
POST http://127.0.0.1:8000/agent/chat/complete
请求:
{
  "message": "测试 Service 分层",
  "temperature": 0.7
}
预期返回:
{
  "reply": "模拟 Agent 收到:测试 Service 分层",
  "model": "demo-agent"
}
如果成功,就说明我们在没有改变接口外部行为的前提下,把业务逻辑从 Router 抽离到了 Service。
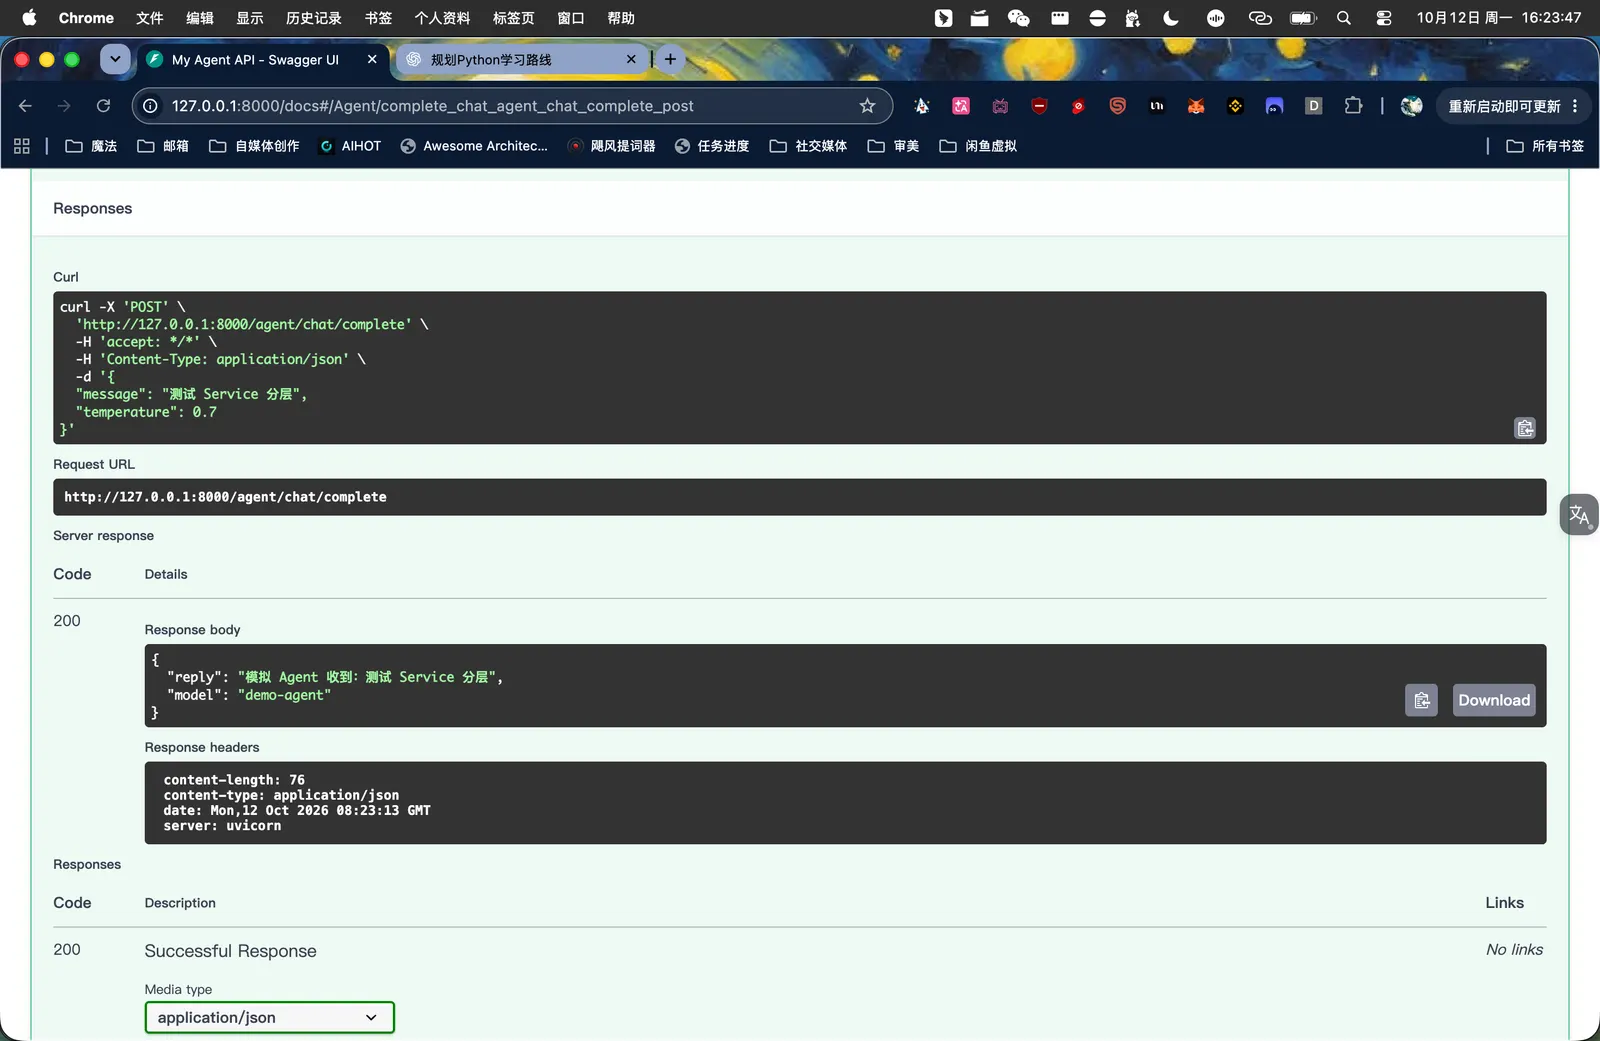
5. 完成后的项目结构
python-engineering/
├── app/
│   ├── __init__.py
│   ├── main.py
│   ├── dependencies.py
│   ├── routers/
│   │   ├── __init__.py
│   │   ├── users.py
│   │   └── agent.py
│   ├── schemas/
│   │   ├── __init__.py
│   │   └── chat.py
│   └── services/
│       ├── __init__.py
│       └── agent_service.py
├── pyproject.toml
└── uv.lock
8. pytest
1. 为什么需要自动化测试?
你之前每次修改代码,都需要:
-
启动 Uvicorn。
-
打开 Swagger。
-
手动输入请求。
-
检查响应是否正确。
但如果项目有几十个接口,每次都这样检查,效率就很低。
pytest 可以让我们把这些验证过程写成 Python 代码,然后通过一条命令自动执行。
例如:
def test_add():
    assert 1 + 1 == 2
其中:
assert 1 + 1 == 2表示断言这个条件必须成立。
-
条件成立:测试通过。
-
条件不成立:测试失败。
这就是自动化测试最基础的原理。
2. 安装测试工具
进入项目:
cd ~/python-engineering安装:
uv add --dev pytest我们先只安装 pytest。FastAPI 接口测试还会用到 httpx,但之前已经安装过了。
3. 创建第一个接口测试
创建测试目录:
mkdir -p tests
nano tests/test_api.py
下面是 tests/test_api.py 的完整代码,可以直接粘贴。
from fastapi.testclient import TestClient

from app.main import app

client = TestClient(app)


def test_health():
    response = client.get("/health")

    assert response.status_code == 200
    assert response.json() == {"status": "ok"}


def test_agent_config():
    response = client.get("/agent/config")

    assert response.status_code == 200
    assert response.json()["model"] == "demo-agent"


def test_invalid_chat():
    response = client.post(
        "/agent/chat/complete",
        json={
            "message": "",
            "temperature": 3
        }
    )

    assert response.status_code == 422
    assert len(response.json()["detail"]) == 2
这里有一个新东西:
client = TestClient(app)TestClient 是 FastAPI 提供的测试客户端。
它可以在测试代码中直接调用 FastAPI 应用,不需要提前启动 Uvicorn,也不需要通过真实网络端口访问接口。
我们先写三个测试:
| 测试函数 | 验证内容 |
|---|---|
test_health() |
健康检查接口返回 200 |
test_agent_config() |
依赖注入能够提供正确配置 |
test_invalid_chat() |
Pydantic 能够拦截非法请求 |
第三个测试还有一个特点:因为请求参数不合法,FastAPI 会在执行 Service 之前返回 422,因此不会向 httpbin 发起请求。
4. 运行 pytest
在项目根目录执行:
.venv/bin/python -m pytest tests/test_api.py -v如果一切正常,你应该看到类似:
tests/test_api.py::test_health PASSED
tests/test_api.py::test_agent_config PASSED
tests/test_api.py::test_invalid_chat PASSED

================ 3 passed ================
这里:
-
PASSED:测试通过。 -
FAILED:断言失败。 -
ERROR:测试执行过程中出现错误。
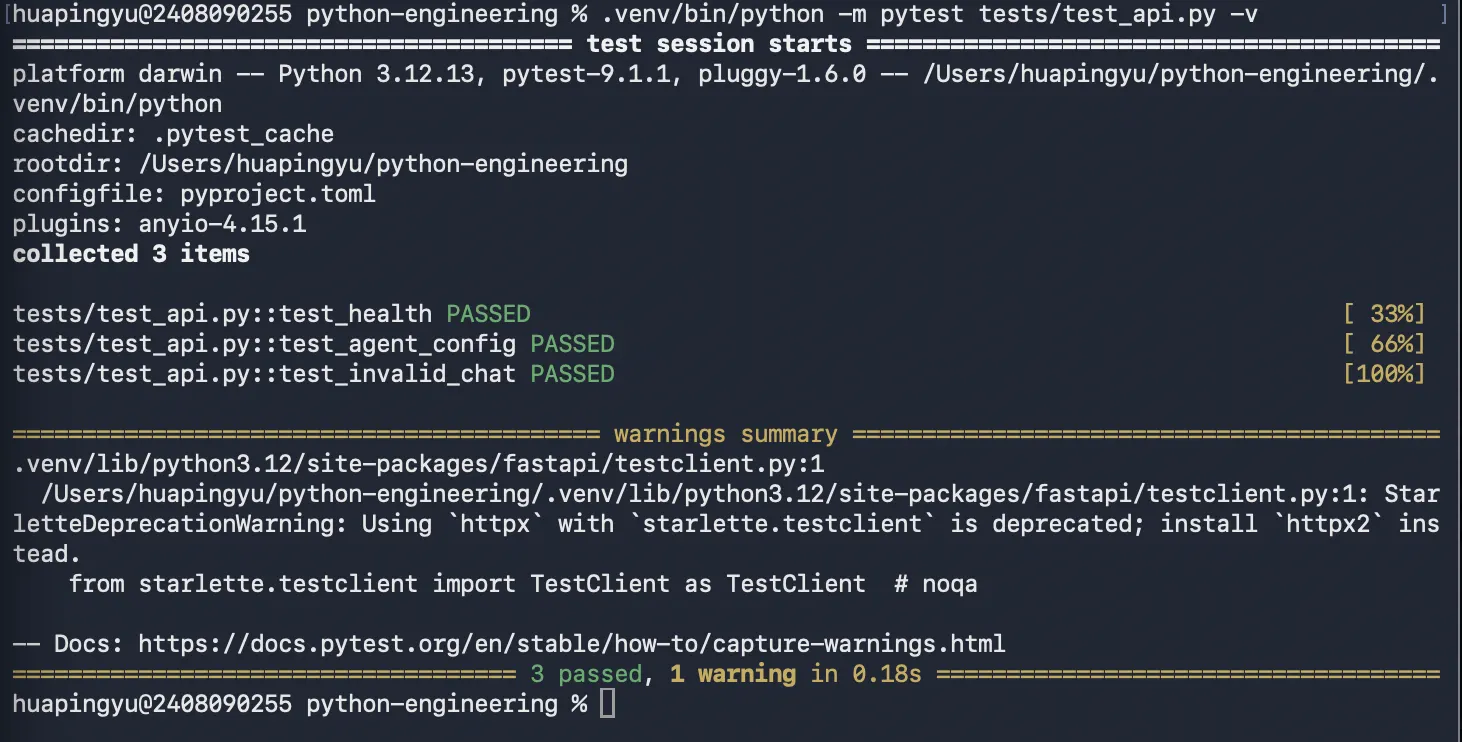
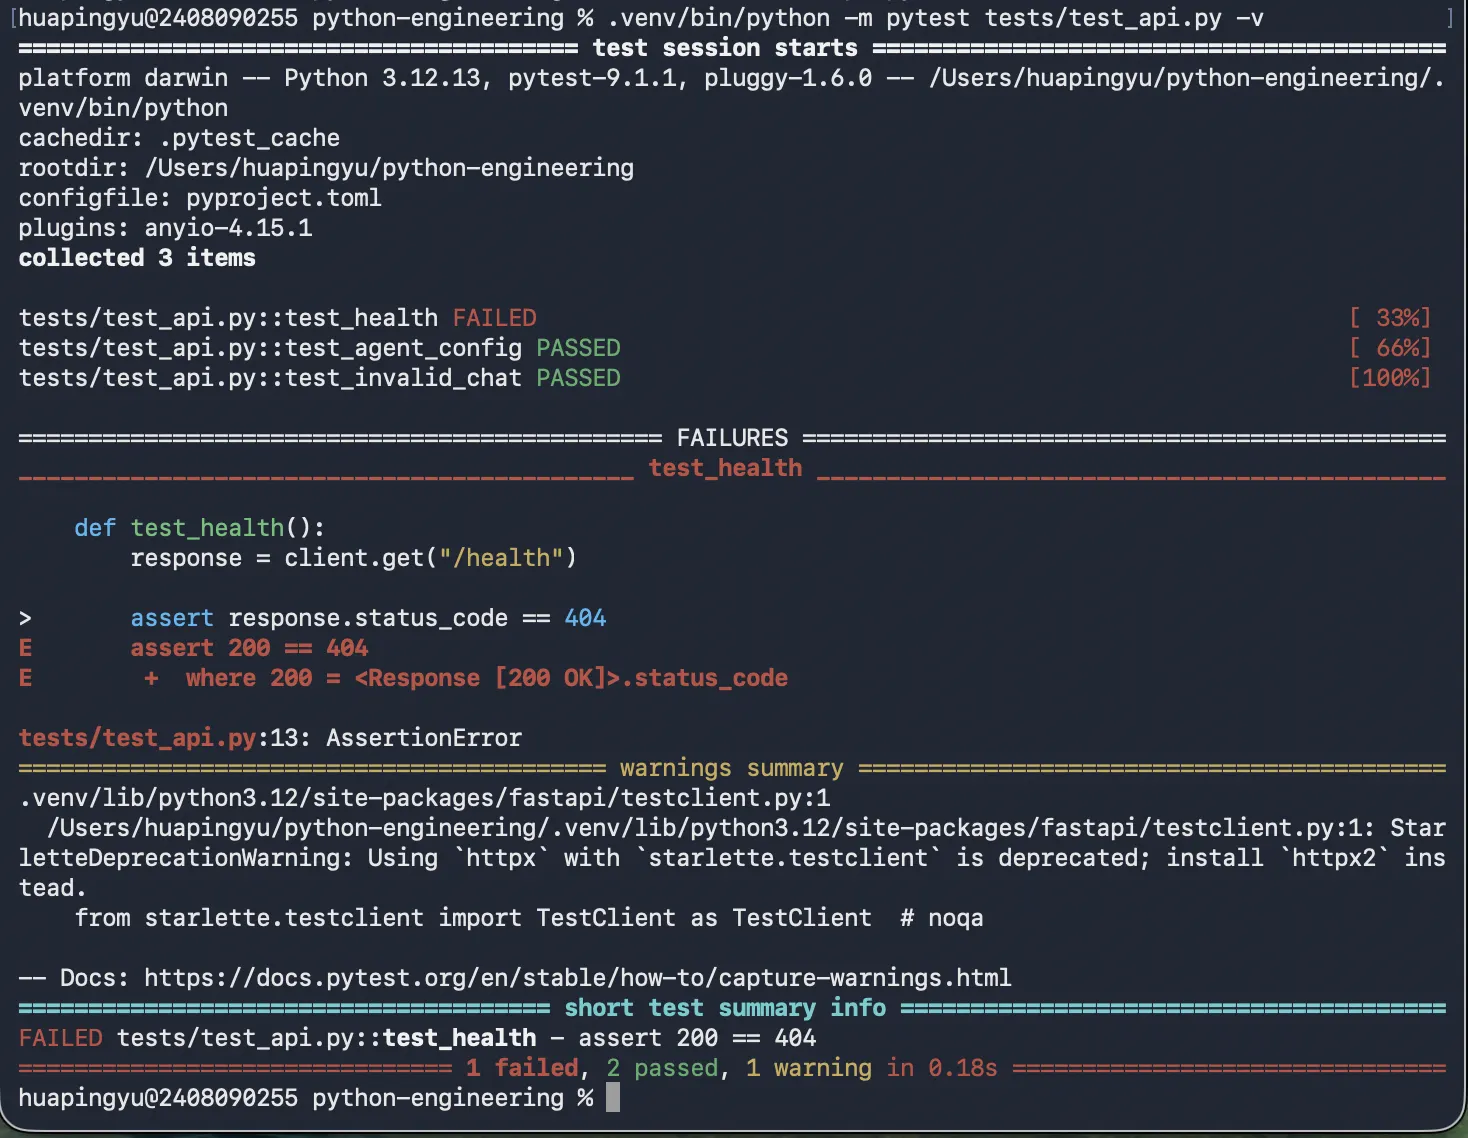
5. 再做一个小实验
当三个测试全部通过后,打开:
nano tests/test_api.py找到:
assert response.status_code == 200把 test_health() 中的这一行临时改成:
assert response.status_code == 404然后重新运行 pytest。
这次应该会出现 FAILED,因为实际返回的是 200,而你要求它必须等于 404。
观察 pytest 输出的错误位置和实际值,然后把断言改回 200。
这个实验的目的,是让你熟悉 pytest 如何帮助我们定位问题。
9. Mock:模拟外部依赖
1. Mock 究竟解决什么问题?
回顾一下我们的 Agent API:
客户端
   ↓
FastAPI Router
   ↓
Agent Service
   ↓
httpx.AsyncClient
   ↓
httpbin.org
假设我们现在要测试 Agent Service。
如果每次运行测试,都要真正访问 httpbin.org,就会有几个问题:
-
网络断了,测试可能失败。
-
外部服务故障,测试可能失败。
-
测试真实大模型 API,还可能消耗 Token 和费用。
但我们真正想验证的是:
自己的代码能不能正确处理外部 API 返回的数据。
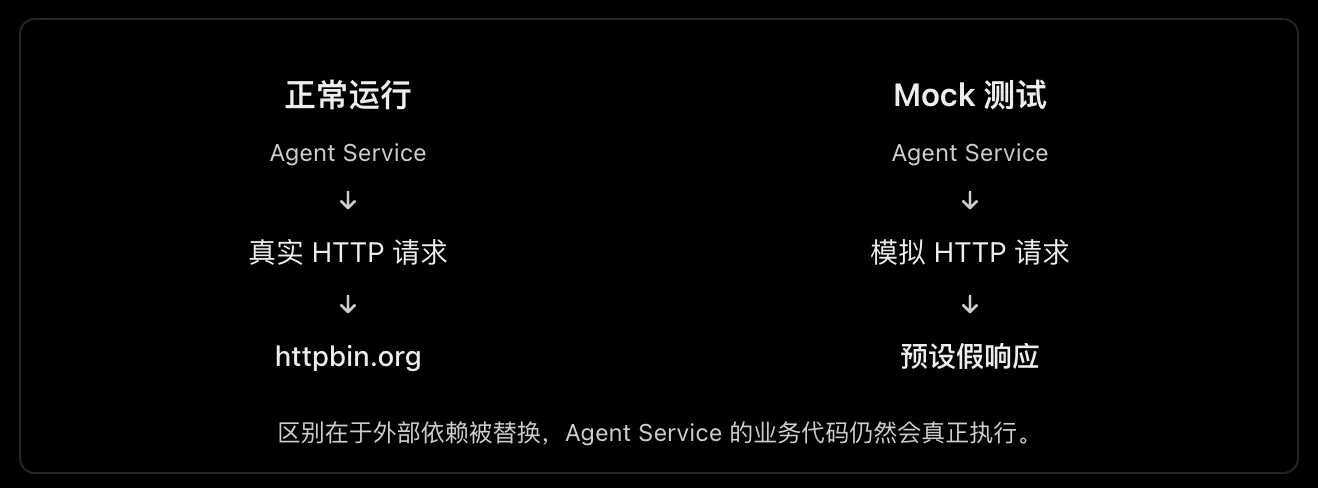
因此,我们可以使用 Mock,在测试时让一个假的外部响应替代真实响应。
2. 编写第一个 Mock 测试
这次使用 httpx 自带的 MockTransport,不需要安装新依赖,也不需要修改业务代码。
第一步:创建测试文件
cd ~/python-engineering
nano tests/test_agent_service.py
下面是 tests/test_agent_service.py 的完整代码,可以直接粘贴。
import asyncio
import httpx

from unittest.mock import patch

from app.schemas.chat import ChatRequest
from app.services.agent_service import generate_reply

def test_generate_reply_with_mock():

    # 1. 定义假的外部 API 响应
    def mock_handler(request: httpx.Request):
        assert request.method == "POST"
        assert str(request.url) == "https://httpbin.org/post"

        return httpx.Response(
            status_code=200,
            json={
                "json": {
                    "message": "你好,Mock",
                    "model": "demo-agent"
                }
            }
        )

    # 2. 创建 Mock HTTP 客户端
    mock_client = httpx.AsyncClient(
        transport=httpx.MockTransport(mock_handler)
    )

    # 3. 用假的客户端替换真实客户端
    with patch(
        "app.services.agent_service.httpx.AsyncClient",
        return_value=mock_client
    ):
        request = ChatRequest(
            message="你好,Mock",
            temperature=0.7
        )

        config = {"model": "demo-agent"}

        result = asyncio.run(generate_reply(request, config))

    # 4. 验证业务结果
    assert result.reply == "模拟 Agent 收到:你好,Mock"
    assert result.model == "demo-agent"
这里重点理解两个东西。
第一个:MockTransport
httpx.MockTransport(mock_handler)它让 HTTP 请求不再发送到真实网络,而是交给 mock_handler() 处理。
我们在 mock_handler() 中直接返回:
httpx.Response(
    status_code=200,
    json={
        "json": {
            "message": "你好,Mock",
            "model": "demo-agent"
        }
    }
)
这相当于假装 httpbin 已经返回了这个 JSON。
第二个:patch()
with patch(
    "app.services.agent_service.httpx.AsyncClient",
    return_value=mock_client
):
它的作用是:
在这个 with 代码块内,当 generate_reply() 创建 httpx.AsyncClient 时,让它拿到我们准备好的 Mock 客户端。
离开 with 后,这个替换会恢复。
所以它不会永久修改你的 Agent Service。
3. 运行测试
执行:
.venv/bin/python -m pytest tests/test_agent_service.py -v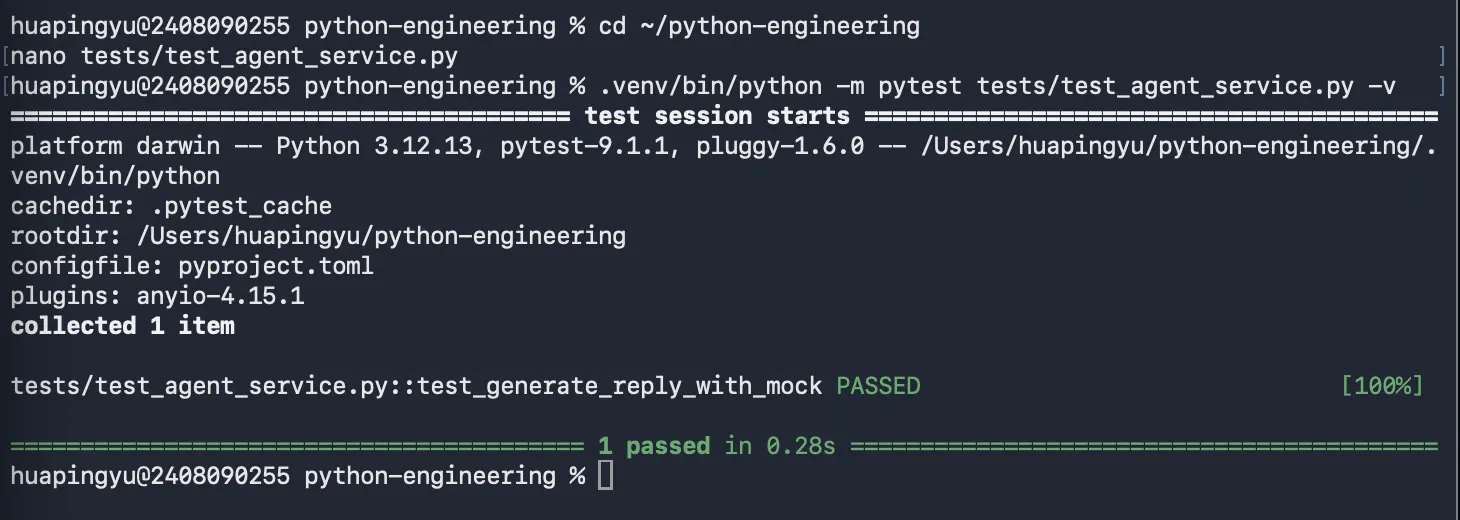
这个测试不需要启动 Uvicorn,也不需要连接 httpbin。
4. 最后理解一下这次测试的意义
我们测试的不是假的 generate_reply()。
实际上,generate_reply() 里面的这些代码仍然会执行:
response = await client.post(url, json=payload)
response.raise_for_status()

data = response.json()
received = data["json"]

return ChatResponse(
    reply=f"模拟 Agent 收到:{received['message']}",
    model=received["model"]
)
只有外部 HTTP 通信被 Mock 替换了,真正的业务逻辑没有被替换。
这也是 Mock 最重要的价值:隔离不稳定的外部依赖,验证自己的代码。
截图确认成功:
test_generate_reply_with_mock PASSED
1 passed in 0.28s
这说明你已经成功使用 Mock 替代真实 HTTP 请求,同时验证了 Agent Service 的正常响应。
接下来完成 Mock 的最后一个练习:模拟外部 API 返回 500。
做完这一项,pytest 和 Mock 的基础学习就全部结束,进入最终综合练习。
5. 添加第二个测试
打开文件:
cd ~/python-engineering
nano tests/test_agent_service.py
这次不需要清空文件,只需要做两处修改。
修改 1:增加 import
在文件顶部添加:
import pytest
from fastapi import HTTPException
原有的 import 全部保留。
修改 2:在文件末尾追加测试函数
def test_generate_reply_external_error():

    # 1. 模拟外部 API 返回 500
    def mock_handler(request: httpx.Request):
        return httpx.Response(
            status_code=500,
            json={"error": "Internal Server Error"}
        )

    # 2. 创建模拟客户端
    mock_client = httpx.AsyncClient(
        transport=httpx.MockTransport(mock_handler)
    )

    # 3. 替换真实 HTTP 客户端
    with patch(
        "app.services.agent_service.httpx.AsyncClient",
        return_value=mock_client
    ):
        request = ChatRequest(
            message="测试异常处理",
            temperature=0.7
        )

        config = {"model": "demo-agent"}

        # 4. 验证是否抛出预期异常
        with pytest.raises(HTTPException) as exc_info:
            asyncio.run(generate_reply(request, config))

    # 5. 验证异常的状态码和信息
    assert exc_info.value.status_code == 502
    assert "500" in exc_info.value.detail
理解这次唯一的新知识点
with pytest.raises(HTTPException) as exc_info:
    asyncio.run(generate_reply(request, config))
pytest.raises() 表示:
我预期这段代码会抛出指定类型的异常。
它的判断逻辑是:
| 实际发生的情况 | 测试结果 |
|---|---|
抛出 HTTPException,且后续断言通过 |
PASSED |
| 没有抛出异常 | FAILED |
| 抛出了其他类型的异常 | FAILED |
抛出 HTTPException,但状态码不是 502 |
FAILED |
其中:
exc_info.value.status_code就是读取捕获到的 HTTPException 对象的状态码。
而:
assert "500" in exc_info.value.detail则是确认错误信息包含上游返回的 500。
这里需要区分两个状态码:
-
500:我们模拟的外部 API 返回的错误。
-
502:Agent Service 将外部错误转换成对客户端的 HTTP 错误。
6. 运行测试
执行:
.venv/bin/python -m pytest tests/test_agent_service.py -v预期结果:
test_generate_reply_with_mock PASSED
test_generate_reply_external_error PASSED

================ 2 passed ================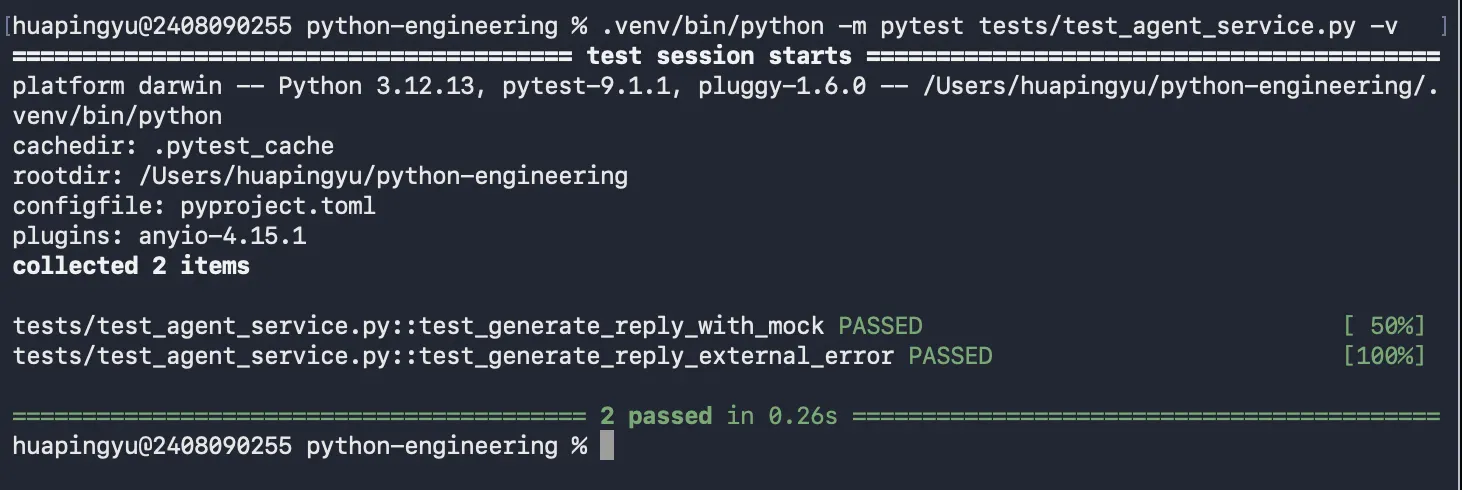
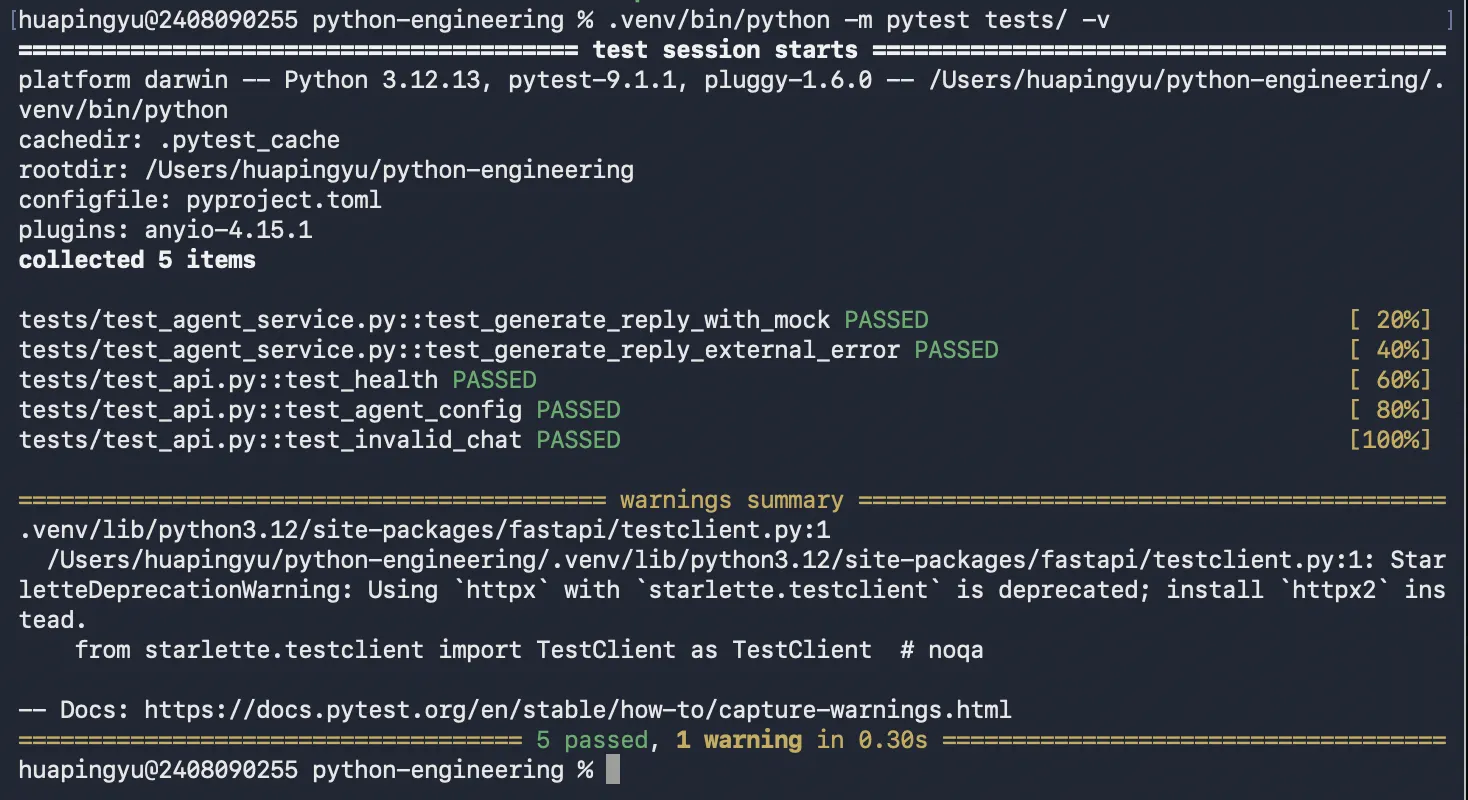
接着再运行整个测试目录:
.venv/bin/python -m pytest tests/ -v如果你已经把之前 test_health() 中的断言恢复为 200,那么预期应该是:
test_health PASSED
test_agent_config PASSED
test_invalid_chat PASSED
test_generate_reply_with_mock PASSED
test_generate_reply_external_error PASSED

================ 5 passed ================